Почему-то во всех командах, где я работал, я всегда отвечал за оценку, сколько нам нужно GPU. И за то, как эту оценку сделать поменьше.
За годы это вошло в интуицию, и со стороны я могу выглядеть как участник паранормального шоу: смотрю на задачу и говорю — «вам будет нужно сто H100, но если постараться, можно и за тридцать». Хорошо, когда такой человек угадывает с точностью осьминога Пауля. Но разница в три раза может стоить сотни миллионов рублей, так что лучше это число аккуратно посчитать. Особенно если вы не осьминог Пауль.
А берётся оценка не только из размера LLM. Одна и та же модель на одном и том же железе может стоить вам в три раза дороже или в три раза дешевле — в зависимости от того, насколько заботливо вы к ней отнеслись. Никакой мистики в этом нет, это обычное инженерное ремесло. Просто я его проделал много раз и запомнил, а в первый раз пришлось сесть и разобраться.
Вот сейчас мы вместе сядем и разберёмся. Как посчитать, сколько карт нужно под ваш сервис, откуда берётся разброс в разы и что сделать, чтобы оказаться ближе к нижней границе. В конце статьи вас ждет пошаговый план, как применить это все на практике. Поехали.
Глава 1. Путь одного запроса
Прежде чем считать деньги, нужно понимать, за что вы платите. Разберём базово, что происходит, когда пользователь отправил запрос. То есть как LLM генерирует ответ, или, по-научному, как устроен инференс.
Ответ рождается по одному токену
LLM оперирует токенами — кусочками текста из фиксированного словаря. Входной промпт разбивается на токены, ответ предсказывается тоже в токенах, а потом декодируется обратно в символы. Для русского языка одно слово — это примерно один-два токена.
Токен — это единица работы модели и единица вашего счёта. Дальше вся экономика считается в них.
Модель предсказывает следующий токен, дописывает его к тексту и запускается заново. И так до конца ответа. Это называется авторегрессией, и это главная причина, почему инференс такой медленный и дорогой.
Обойти это нельзя: каждый следующий токен зависит от предыдущего. Нельзя посчитать десять токенов сразу, потому что для третьего нужно знать, чем оказался второй. Ответ на 500 токенов — это 500 последовательных запусков модели.
Две фазы: prefill и decode
Из этого следует, что инференс распадается на два непохожих этапа.
Prefill — обработка входного промпта. Все токены известны заранее, поэтому они прогоняются через модель за один проход. Отсюда время до первого токена: пользователь отправил запрос и ждёт, пока модель прочитает то, что он написал.
Decode — генерация ответа. Здесь по одному токену за раз, столько раз, сколько токенов в ответе. Отсюда скорость, с которой текст ползёт по экрану.
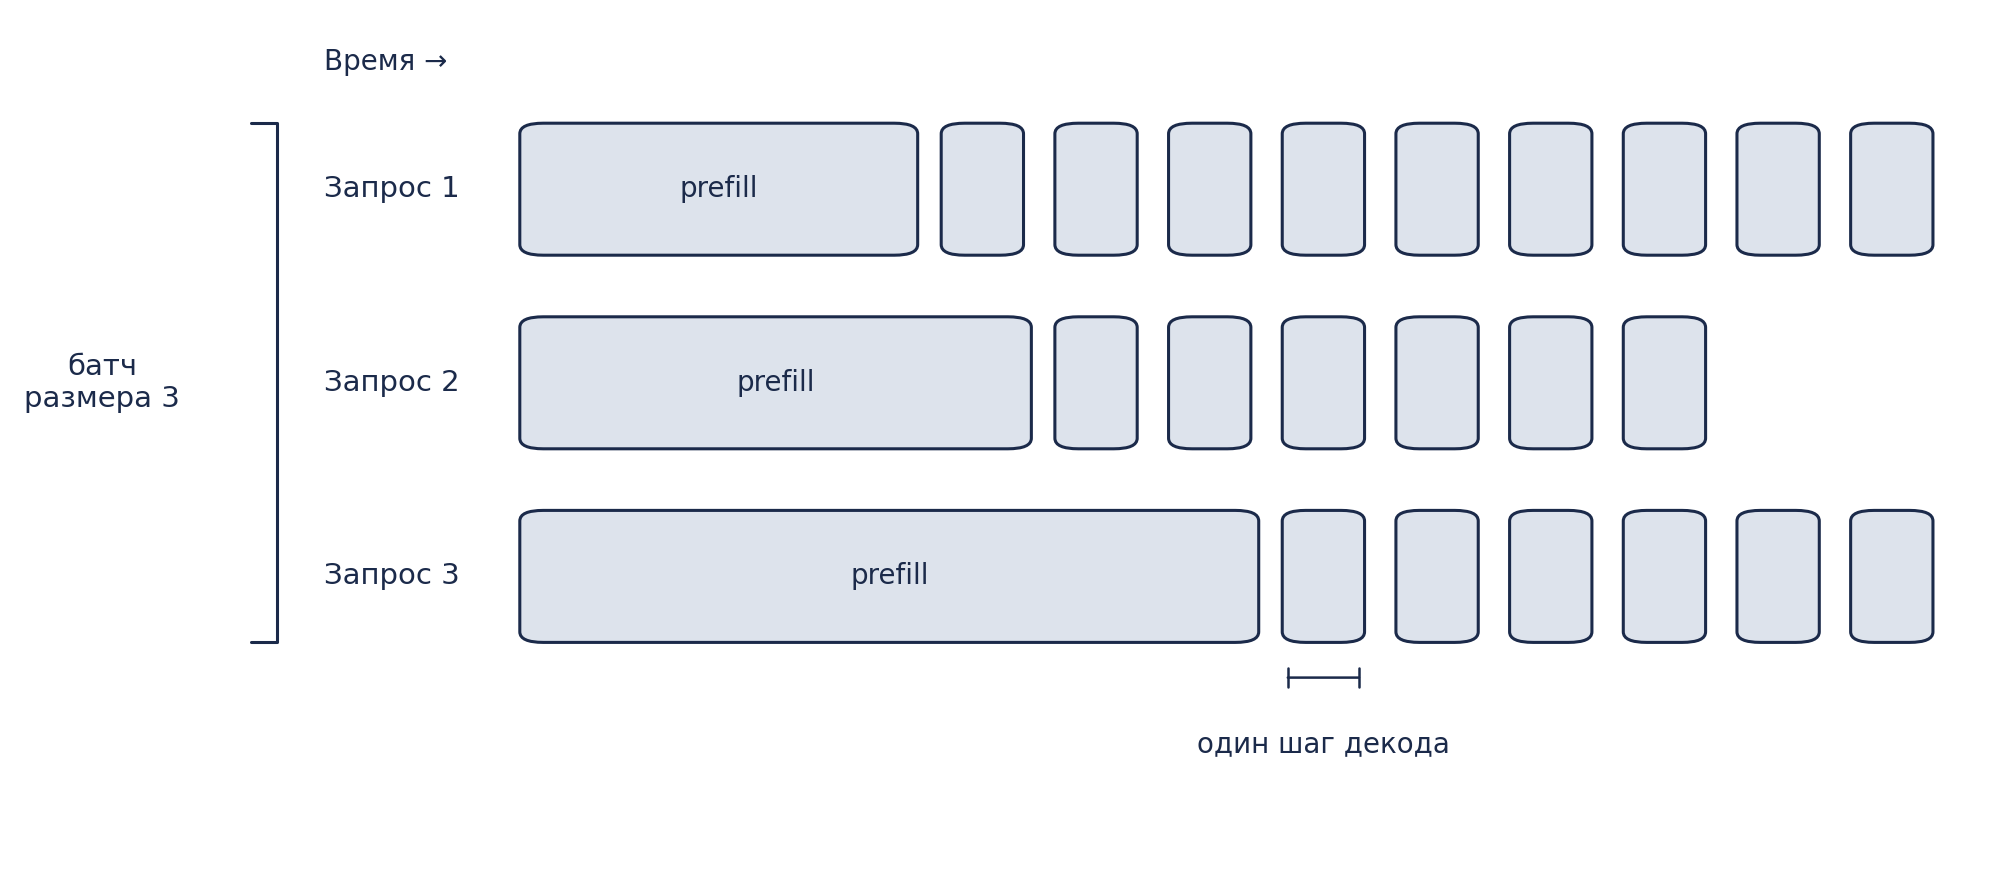
Разница между ними принципиальная и упирается в устройство железа. GPU спроектирована под массовые параллельные вычисления — ей нужно много однотипной работы одновременно. Prefill даёт ровно это: тысячи токенов сразу, есть чем заняться. А decode на каждом шаге приносит один-единственный токен, и карта грустит холодной.
Отсюда, кстати, растёт та разница в ценах, которую вы видите у любого API-провайдера: входные токены стоят в три-пять раз дешевле выходных. Это не маркетинг, а прямое отражение того, что prefill обрабатывает промпт пачкой, а decode выдаёт по одному.
Там же вы найдёте и третью цену — за cached input, ещё в несколько раз дешевле обычного входа. Работает это так: если у запросов одинаковое начало (системный промпт, инструкции, примеры), его достаточно обработать один раз и дальше переиспользовать. Называется кэширование префиксов, на агентских нагрузках экономит почти весь prefill.
Как обрабатывать несколько пользователей
Пользователей у сервиса много, а карта одна. Отвечать им по очереди неэффективно: пока карта возится с одним запросом, остальные ждут.
Поэтому запросы группируют в пачку — батч — и инферят параллельно на одной карте.
Работает это потому, что веса модели одни и те же для всех. Чтобы сгенерировать очередной токен, карта прогоняет через себя все миллиарды весов модели. И не важно, для одного пользователя она это делает или для пятидесяти — веса те же самые. Прочитали один раз, обслужили всю пачку.
Теперь мы базово понимаем, как работает инференс LLM. В следующей главе разберёмся, что именно в нём тормозит.
Глава 2. Проблема в памяти, а не в мощности карты
Видеокарта состоит из двух классов памяти.
DRAM — относительно дешёвая и относительно медленная. Именно туда вы загружаете модель, когда поднимаете инференс. Допустим, у вас модель на 35B параметров, и вы храните её в fp16 (2 байта на вес). Значит, нужно 70 ГБ DRAM. Дальше разбираем на примере H100: там 80 ГБ. Влезло.
SRAM — дорогая и быстрая. Дорогого и быстрого логично давать умеренно, поэтому её примерно в тысячу раз меньше. Зато SRAM сидит вплотную к ядрам, на которых и происходят вычисления. Поэтому веса модели перетекают из DRAM в SRAM — на H100 со скоростью 3,3 ТБ/с.
Тут немного математики, держитесь
Теперь самая тупая математика. Чтобы перетащить 70 ГБ весов со скоростью 3,3 ТБ/с, нужно 70 / 3300 = 21 мс.
Декодинг идёт токен за токеном, то есть ради каждого проклятого токена надо каждый раз прогнать через шину эти проклятые 70 гигабайт. Поздравляю, ваша максимальная скорость — 1000 / 21 ≈ 47 токенов в секунду.
Прочувствуйте это. Мы ещё ничего не считаем. При полной загрузке 70 ГБ весов вы никак не сделаете декодинг на одной H100 быстрее 47 токенов в секунду.
Это, мне кажется, действительно забавно. Вы купили за много миллионов рублей H100, которая умеет делать ОДИН КВАДРИЛЛИОН операций в секунду. Я даже гуглил это слово. А карта сидит холодная, потому что всё время уходит на перекачку весов. Это называется тупизм memory-bound режим.
Более мощная карта не поможет
Легко подумать, что решение — купить карту помощнее. Не поможет.
Из наших 21 миллисекунды на сами вычисления уходит примерно 0,1 мс. Всё остальное время карта просто ждёт, пока приедут данные. Сделайте вычисления в десять раз быстрее — получите 20,9 мс вместо 21. Ускорение на полпроцента за десятикратную цену.
Ускоряет тут ровно одно: скорость памяти. Вдвое быстрее память — вдвое быстрее генерация. Это и есть memory-bound: узкое место не в том, как быстро карта считает, а в том, как быстро к ней доезжают данные.
Чтобы не быть настолько идиотом, возникает логичная идея. Раз я уж эти проклятущие веса из DRAM в SRAM перегнал — может, я обслужу не один запрос, а сразу несколько? Веса-то одни и те же. Чтобы H100 моя родненькая не стояла холодненькая.
Поздравляю, вы придумали батч. Те же 21 миллисекунда, но на выходе не один токен, а пятьдесят.
Но бесконечно это не работает. Каждый новый запрос в пачке — это дополнительные вычисления: веса те же, а перемножать их надо теперь на пятьдесят разных входов вместо одного. В какой-то момент карта перестаёт успевать считать, и ждать вы начинаете уже не перегона весов из памяти, а того, пока карта досчитает. Это compute-bound режим.
Карта в стойке стоит одинаково — обслуживает она одного пользователя или пятьдесят. Разница только в том, сколько полезной работы вы с неё сняли. Поэтому себестоимость токена определяется не только мощностью железа или размером модели, а тем, насколько плотно набита пачка. То есть насколько хорошо вы утилизируете карту.
Глава 3. Метрики и как их замерять
Базово метрики инференса описывают две вещи: как долго ждать ответа и сколько GPU вы готовы за это заплатить.
Метрики времени ответа
Пользователь ждёт дважды. Сначала после отправки запроса — пока на экране вообще ничего нет. Потом уже во время чтения ответа — пока текст ползёт по экрану.
1. Время до первого токена (TTFT, time to first token). Сколько прошло от момента, когда пользователь нажал «отправить», до появления первой буквы ответа. Это фаза prefill из первой главы плюс ожидание в очереди, если сервер занят. Зависит в первую очередь от длины промпта: чем больше вы отправили модели на вход, тем дольше она это читает.
2. Время между токенами (ITL, inter-token latency). Сколько проходит между появлением соседних букв. То есть скорость, с которой текст ползёт по экрану. Это фаза decode. Определяется ровно тем перегоном весов из DRAM в SRAM, про который была вторая глава. Именно здесь живут наши 21 миллисекунда и 47 токенов в секунду.
3. Полное время ответа. Считается из первых двух:
полное время = TTFT + количество токенов в ответе × ITLПолное время зависит от того, сколько токенов выдаст модель. Поэтому самое наивное правило ускорения инференса — попросить LLM быть лаконичнее. С людьми, кстати, тоже работает.
А ещё формула полезна для планирования: она переводит терпение пользователя в требования к железу. Пользователь готов ждать 5 секунд, ответ у вас обычно 300 токенов — значит, вам нужно ITL около 16 миллисекунд.
Метрики пропускной способности
Вторая половина вопроса — сколько вы за эту скорость платите. Эти метрики показывают, какую нагрузку держат ваши GPU.
Токены в секунду со всех карт. Сколько полезной работы вы сняли с железа. Пользователю на это число плевать, а вам оно про деньги: разделите стоимость GPU-часа на количество токенов и получите себестоимость.
Считается просто:
токенов в секунду = размер батча / ITLНапример, батч 50 при ITL 25 мс даёт 2000 токенов в секунду со всей карты. При этом каждый отдельный пользователь видит только 40 токенов в секунду — свою долю от общего пирога.
Запросы в секунду (RPS). Сколько пользователей одновременно выдерживает ваше железо.
Переводится из токенов простой прикидкой: если ответ обычно 300 токенов, а карта выдаёт 2000 токенов в секунду, то вы сможете обслужить примерно 6–7 запросов за секунду.
Именно RPS — то число, ради которого всё считается. Токены в секунду это промежуточная величина, а карты вы закупаете под запросы пользователей.
Как замерять на практике
Две вещи, которые чаще всего портят замер.
1. Смотрите перцентили, а не средние. Допустим, у 90% пользователей ITL 15 мс, а у 10% — 115 мс. Среднее получится 25 мс и будет выглядеть прилично. При этом каждый десятый видит рваную генерацию с зависаниями.
Поэтому смотрят перцентили. p50 — это медиана: половина пользователей получила ответ быстрее, половина медленнее. Типичный опыт. p95 и p99 показывают, что происходит у самых невезучих 5% и 1% — то есть когда всё сошлось плохо.
В инференсе это особенно важно, потому что у одного запроса не одно измерение ITL, а сотни — по одному на каждый токен. Плохой p99 означает не «одному пользователю не повезло», а «каждый видит несколько зависаний за один ответ».
2. Собирайте честную корзину запросов. Замер на синтетике из одинаковых коротких промптов даст красивые цифры, которые развалятся в бою. Нужно продовое распределение: реальные длины промптов, реальные длины ответов, реальная доля длинных запросов.
Сам замер. Сначала выгружаете свои реальные запросы из логов в .jsonl — по одному запросу на строку, в поле prompt. Дальше поднимаете сервер и гоняете тест. Например, если вы будете для инференса использовать библиотеку vLLM:
vllm serve my-model

# в соседнем терминале
vllm bench serve \
  --model my-model \
  --dataset-name custom \
  --dataset-path my_requests.jsonl \
  --request-rate 5 \
  --percentile-metrics ttft,tpot,itl
Теперь у вас есть цифры. В следующей главе поймём, можно ли сделать побыстрее. И сколько это будет стоить.
Глава 4. Быстрее или дешевле: главный размен
Во второй главе я вас капелюшечку обманул. Помимо весов модели, по шине приходится гонять ещё одну вещь.
Чтобы не пересчитывать заново всё, что уже посчитано, модель хранит матрицу с результатами прошлых вычислений. Называется KV-кэш. Подробнее про него самые любознательные инженеры могут почитать вот тут.
И иногда он занимает памяти больше, чем миллиардные веса модели.
Тут немного математики, боритесь или пропускайте
KV-кэш на один токен занимает:
2 (K и V) × слои × число KV-голов × размер головы × байтДопустим, у нас 60 слоёв, 8 KV-голов, размер головы 128, и храним кэш в fp16:
2 × 60 × 8 × 128 × 2 = 245 760 байт ≈ 246 КБ на токенТогда, если контекст 2000 токенов на запрос:
245 760 × 2000 ≈ 0,49 ГБПолгигабайта памяти. На один запрос.
И что нам с этих полгигабайта?
Гоняем по шине = размер модели + батч × размер KV-кэшаИ тут ключевое: веса общие для всех запросов в батче, а KV-кэш у каждого свой. Поэтому веса делятся на всех, а кэши складываются.
Дальше будем считать на той же модели, но в fp8 (тратим на каждый вес модели 1 байт) — это вдвое компактнее, 35 ГБ вместо 70. Почему так делают и что при этом теряется, разберём в следующей главе.
Если батч маленький, KV-кэш мал, на него можно забить. Но если батч 100, то кэши уже 50 гигабайт — больше, чем сама модель, и основное время уходит на их перегон.
Итого очень понятный размен. Больше батч — мы загрузили модель один раз и параллельно предсказываем всю пачку. То есть больше пропускная способность карты, то есть можем держать больше запросов, то есть нужно меньше карт. Но при этом больше KV-кэша надо гонять, и дольше пользователь ждёт каждый токен.
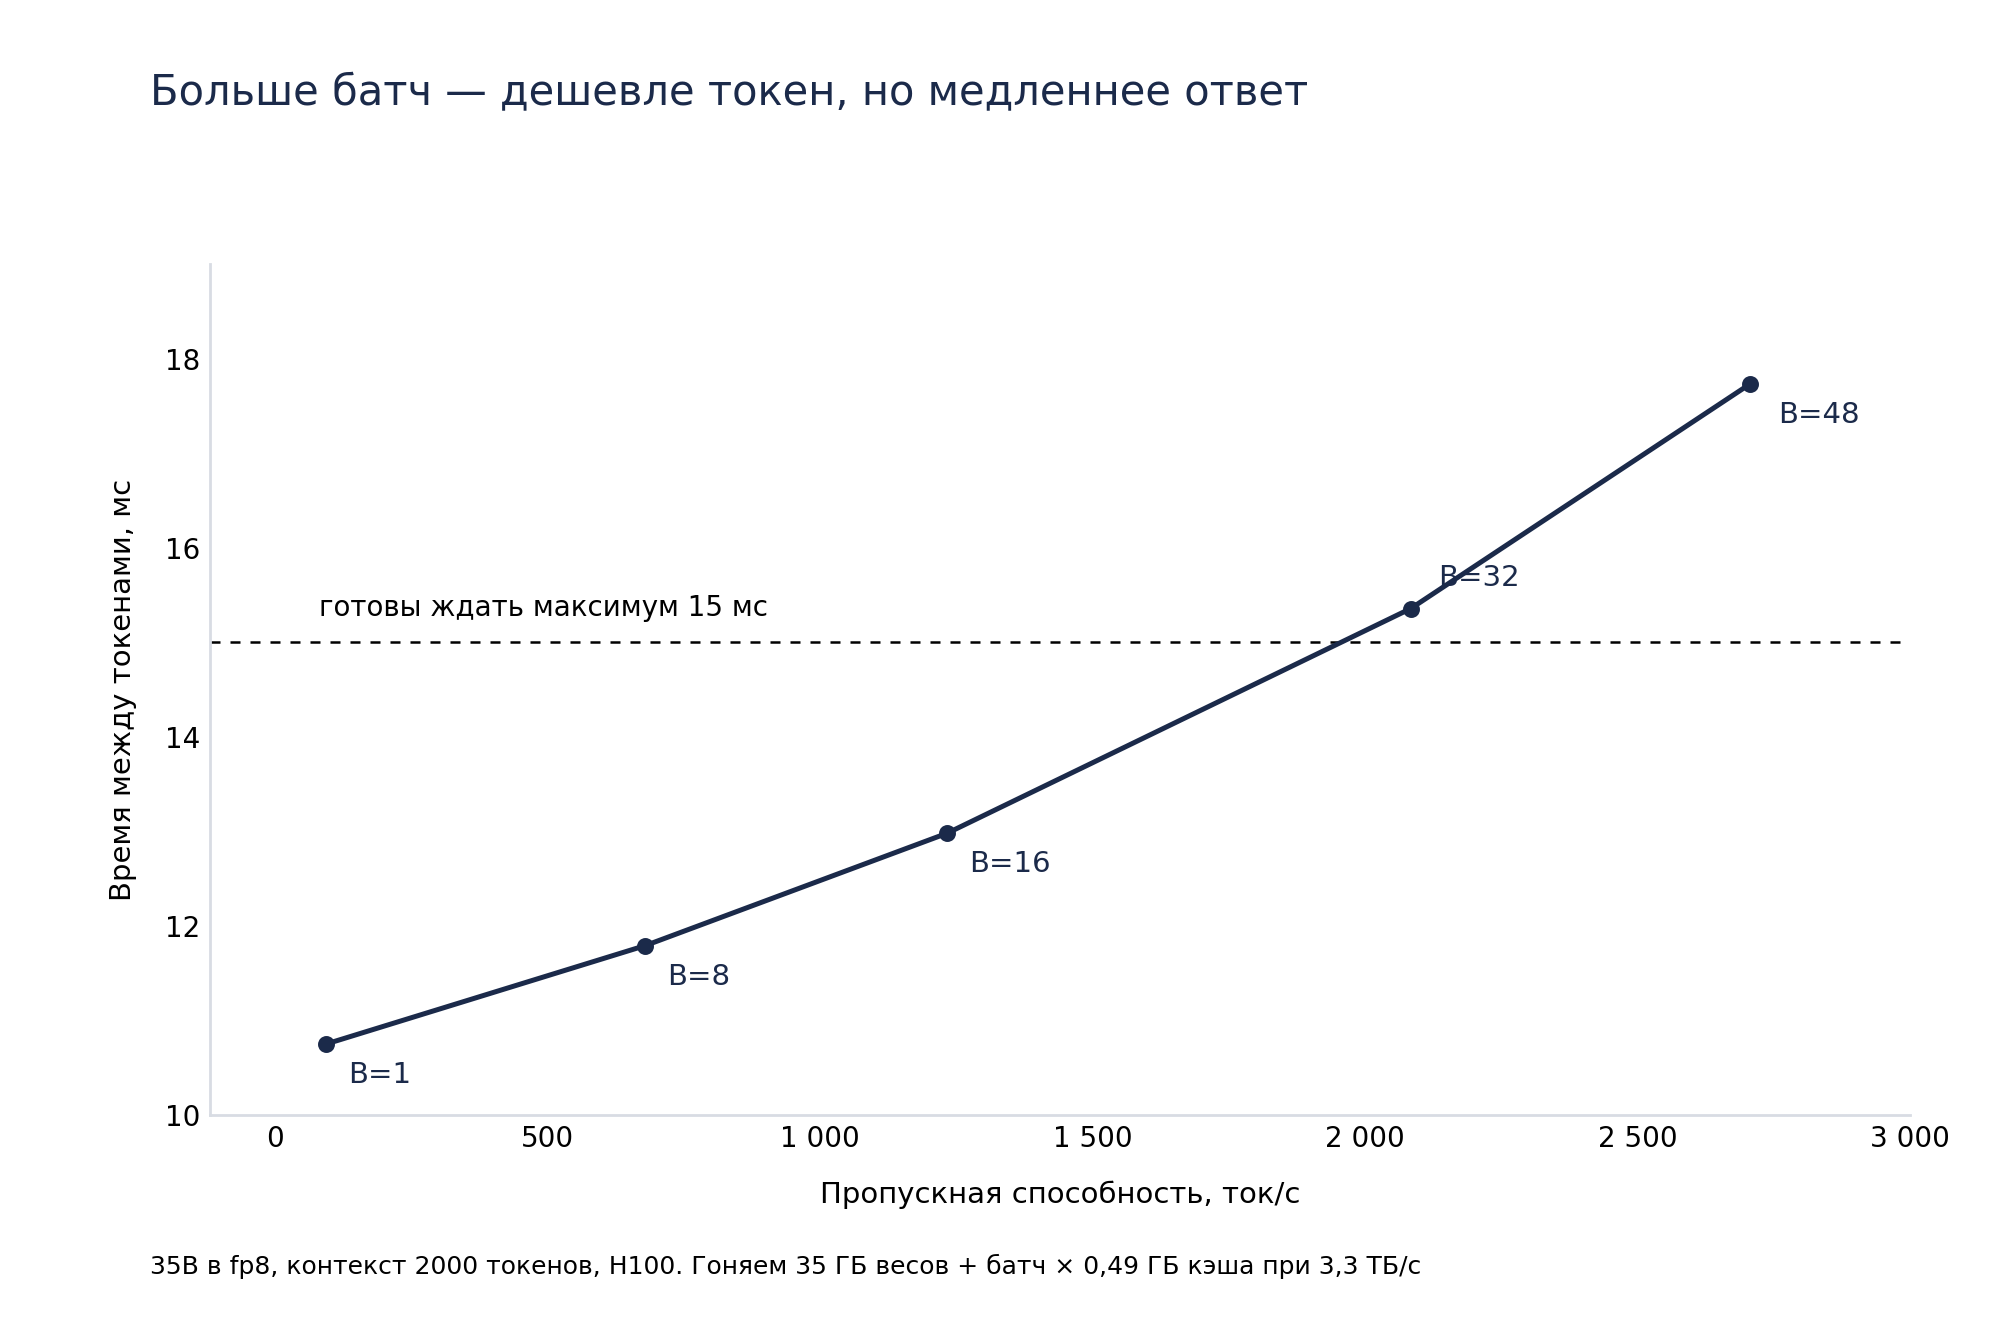
По горизонтали — токены в секунду со всей карты, то есть ваши деньги. По вертикали — время между токенами, то есть терпение пользователя. Точки на кривой — размеры батча.
В третьей главе мы посчитали, сколько миллисекунд между токенами вы готовы отдать: пользователь ждёт 5 секунд, ответ 300 токенов, значит нужно около 16 мс. Проводите на этом уровне горизонтальную линию — и видите, сколько запросов помещается на одну карту, не нарушая обещание.
Это и есть ёмкость вашей конфигурации.
Батч вы не выбираете
Размер батча — не настройка, которую вы ставите в конфиге. Он складывается сам из вашего трафика:
батч ≈ RPS × время жизни одного запросаПять запросов в секунду, ответы по 300 токенов при 16 мс — каждый запрос живёт в системе примерно 5 секунд. Значит, в пачке сидит около 25 запросов. Хотите вы того или нет.
На самом деле настраивается число карт. Добавляете вторую реплику — балансировщик делит трафик пополам, на каждую карту приходится 2,5 запроса в секунду, батч падает до 12, время между токенами падает. График при этом остаётся тем же самым, вы просто съезжаете по нему влево.
Правда, курс тут грабительский: платите вдвое, а выигрываете процентов двадцать во времени. Потому что в левой части графика доминируют веса модели, и уменьшение кэша почти ничего не даёт.
Вот таким образом за счёт добавления GPU можно уменьшать батч и за счёт этого растить скорость ответа. По очень дорогому курсу. Полный план расчёта соберём в конце статьи.
Но помимо размера батча есть ещё много вариантов, как ускорять LLM. Про это следующая глава.
Глава 5. Методы оптимизации инференса
Методов ускорения инференса много, и в статьях они обычно идут списком без всякой логики: квантизация, GQA, MoE, спекулятивный декодинг. Запомнить невозможно.
На самом деле все они атакуют одну из четырёх вещей. Вот формула, из которой это видно:
время одного шага = (веса + батч × кэш) / скорость памятиЭто то, что мы вывели в четвёртой главе. Плюс вторая часть, про то, сколько полезного мы за этот шаг получили:
токенов за шаг = батч × принятых токеновДальше просто. Чтобы каждый токен обходился дешевле, можно:
- Уменьшить веса — гонять по шине меньше миллиардов
- Уменьшить кэш — гонять меньше истории
- Получать больше токенов за один проход — раз уж всё равно прогнали
- Не ездить в память лишний раз — сократить не объём, а количество поездок
Всё остальное — детали реализации. Дальше разберём каждый класс: что там за методы, сколько дают и чем за это платите.
Класс 1. Меньше байт весов
Самый прямой путь: если модель занимает не 70 ГБ, а 35, то и гонять по шине надо вдвое меньше.
Важная оговорка: этот класс отлично работает на маленьком батче и почти бесполезен на большом. Вспомните формулу — при батче 100 кэши весят больше самой модели, и ужимание весов влияет на общее время заметно слабее.
Квантизация весов. Хранить каждый вес не в двух байтах, а в одном (fp8) или даже в половине (int4). Модель ужимается пропорционально.
fp8 — это сейчас дефолт. Качество почти не страдает. Если вы всё ещё гоняете fp16 — это первое, что стоит поменять.
int4 ужимает вчетверо, но качество проседает, и заметно это в первую очередь на длинных ответах и на коде. Имеет смысл, когда модель иначе не влезает в память или когда у вас мало пользователей и важна скорость каждого.
MoE (Mixture of Experts). Модель разбита на много «экспертов», и на каждый токен работает только небольшая их часть. Модель на 400 миллиардов параметров может задействовать 30 миллиардов на токен — то есть гонять по шине в тринадцать раз меньше при качестве большой модели.
Звучит как чудо, но есть нюанс: разные запросы в пачке будят разных экспертов. При батче в несколько десятков объединение покрывает почти всех, и гонять приходится всё равно всю модель. Так что MoE — это не столько про скорость, сколько про качество за те же деньги. На маленьком батче выигрыш реальный, на большом — тает.
Выбирать MoE или нет, вы обычно не можете: это свойство модели, а не настройка. Но знать полезно, чтобы не удивляться, почему модель на 400B работает быстрее, чем модель на 70B.
Просто взять модель поменьше. Самый грубый рычаг и часто самый действенный. Модель в пять раз меньше стоит примерно в пять раз дешевле, и это единственный метод из всего списка, который улучшает вообще всё сразу: и веса, и кэш, и вычисления.
Вопрос только в том, справится ли она с вашей задачей. Обычно ответ «на простых запросах справится» — отсюда роутинг, про который будет в седьмой главе.
А если готовая маленькая модель не тянет, её можно обучить под себя. Это называется дистилляцией: берёте большую модель, прогоняете через неё свои реальные запросы и на её ответах учите маленькую. Маленькая перенимает поведение большой на вашем узком домене и справляется там заметно лучше, чем если бы её учили с нуля. Это уже не настройка инференса, а отдельный проект с данными и обучением — но если у вас однотипная нагрузка на миллионы запросов, разовые затраты могут окупиться пятикратным сокращением парка карт навсегда.
Класс 2. Меньше байт кэша
Второй класс работает наоборот: чем больше у вас батч, тем сильнее эффект.
Помогает он дважды. Во-первых, меньше кэша — меньше гонять по шине, быстрее каждый шаг. Во-вторых, кэш занимает место в памяти карты, и если он ужался вдвое, то на ту же карту влезет вдвое больше пользователей.
Квантизация кэша. По умолчанию кэш хранится в базовом формате модели — как правило, fp16, два байта на число. Причём даже если вы скачали квантованную модель, кэш чаще всего остаётся в исходном формате: квантизация весов и квантизация кэша — это разные настройки. Переключается кэш отдельным флагом.
По качеству fp8 для кэша практически бесплатен, деградация в пределах шума. Более агрессивные варианты (int8, int4) ужимают сильнее, но начинают заметно врать — в первую очередь на длинных контекстах, где ошибки накапливаются от токена к токену.
Это вообще самый недооценённый рычаг из всех. Одна строчка --kv-cache-dtype fp8, а на длинном контексте даёт больше, чем квантизация весов. Половина команд про него просто не знает.
GQA (grouped query attention). Архитектурный приём: вместо того чтобы хранить историю отдельно для каждой «головы» внимания, несколько голов делят одну общую. Кэш ужимается в 8–64 раза при почти неизменном качестве.
Настраивать тут нечего — это свойство модели. Но знать стоит: без GQA большие батчи на длинных контекстах физически невозможны, кэши просто не влезут в память. Все современные модели идут с ней, а вот старые в проде не живут именно поэтому.
Класс 3. Больше токенов за одно чтение
Первые два класса уменьшали то, что мы гоняем. Этот работает с другой стороны: раз уж прогнали, давайте получим с этого побольше.
Батч. Главный метод этого класса и вообще главный рычаг экономии — ему была посвящена вся четвёртая глава. Прогнали веса один раз, обслужили пятьдесят пользователей.
Спекулятивный декодинг. Берём маленькую быструю модель, она набрасывает несколько следующих токенов вперёд. Большая модель проверяет их все за один проход — то есть за одну прогонку весов вместо четырёх.
Если черновик угадал — вы получили четыре токена по цене одного. Если нет — принимаете сколько угадалось, остальное отбрасываете. На практике угадывается два-три токена из четырёх, то есть ускорение примерно вдвое.
Откуда берётся маленькая модель? Самый популярный сейчас метод — EAGLE: вместо отдельной модели к основной приделывается лёгкая надстройка в один слой, обученная предсказывать её же собственные следующие шаги. Она угадывает точнее, чем независимая маленькая модель, потому что видит внутреннее состояние большой. Готовые EAGLE-головы выкладывают для популярных моделей, и движки умеют их подхватывать.
Важно, что качество при этом не страдает вообще. Проверка устроена так, что итоговый текст получается ровно таким же, каким его выдала бы большая модель без всякой спекуляции. Это редкий случай, когда вы ничем не платите — кроме сложности настройки.
Но есть жёсткое ограничение: работает только на маленьком батче. Проверка четырёх токенов вместо одного — это в четыре раза больше вычислений, и на большом батче карта перестаёт успевать считать. Тот самый compute-bound из второй главы.
Класс 4. Меньше лишних походов в память
Первые три класса уменьшали объём того, что мы гоняем. Этот — количество самих поездок.
Дело в том, что модель считает не одной большой операцией, а сотнями мелких: нормализации, активации, сложения. Каждая из них — это отдельный поход в DRAM: забрали данные, что-то с ними сделали, положили обратно. Сама операция занимает микроскопическое время, а поездка туда-обратно — вполне ощутимое.
Слияние ядер (kernel fusion). Лечится это склейкой: несколько операций подряд выполняются за один заход. Забрали данные в SRAM один раз, прогнали через всю цепочку, вернули только финальный результат. Вычислений столько же, поездок вместо пяти — одна.
Самый известный пример слияния — FlashAttention. Чтобы понять контекст, модель сравнивает каждый токен с каждым. Это огромная промежуточная таблица, которая в SRAM не помещается — поэтому наивная реализация выгружает её в медленную DRAM, тут же читает обратно, обрабатывает, снова выгружает. На длинных контекстах эта возка занимает больше времени, чем всё остальное.
FlashAttention считает то же самое, но по кусочкам: берёт такой кусок таблицы, который в SRAM влезает, сразу сворачивает его в результат и переходит к следующему. Целиком таблица нигде не материализуется, в DRAM ездить не нужно. Ответ получается тот же самый, а на длинных контекстах быстрее в разы.
Забавно, что самый знаменитый алгоритм последних лет в области инференса не сократил ни одной операции. Он просто правильно разложил данные по уровням памяти.
Что с этим делать вам. Практически ничего: FlashAttention и основные слияния уже включены по умолчанию в любом нормальном движке. Но знать про этот класс полезно по двум причинам. Во-первых, отсюда берётся разница в скорости между разными движками на одной и той же модели — математика у всех одинаковая, а вот качество ядер разное. Во-вторых, если вы запускаете модель кустарно через голый transformers, вы всего этого не получаете и теряете кратно.
Всё вместе
Хорошая новость: методы из разных классов можно комбинировать. Квантизация весов уменьшает одно слагаемое в формуле, квантизация кэша — другое. Вместе они дают не «два улучшения», а вчетверо меньше трафика по шине.
Плохая новость: комбинируются и потери качества, вызванные каждым методом. Каждый метод по отдельности почти незаметен, но три-четыре агрессивных настройки разом могут дать деградацию, которую вы не ожидали. Поэтому включать их стоит по одному и после каждого замерять качество на своих данных.
| Метод | Куда бьёт | Когда помогает | Цена |
|---|---|---|---|
| Квантизация весов | байты весов | всегда, сильнее на малом батче | fp8 почти нет, int4 — заметная деградация |
| MoE | сколько весов читается на токен | сильнее на малом батче | выбирается вместе с моделью |
| Модель поменьше (дистилляция) | размер модели целиком | всегда | качество |
| Квантизация кэша | байты кэша | сильнее на большом батче и длинном контексте | fp8 почти нет, int4 — сильная деградация |
| GQA | байты кэша | сильнее на большом батче и длинном контексте | выбирается вместе с моделью |
| Батч | токенов за одно чтение весов | всегда | скорость на пользователя |
| Спекулятивный декодинг | токенов за одно чтение весов | на малом батче, на большом бесполезен | сложность настройки |
| FlashAttention | походы в память | на длинном промпте, ускоряет prefill | включено по умолчанию |
Как всё это включается на практике и что из этого умеет ваш движок — в следующей главе.
Глава 6. Выбор движка
Всё, что мы разбирали в предыдущей главе, вы не программируете руками. Этим занимается движок инференса — библиотека, которая загружает модель, собирает батч, управляет памятью и отдаёт ответы по сети.
Выбор движка определяет, какие оптимизации вам вообще доступны и насколько сложно их включить. Разберём три штуки, которые покрывают почти все ситуации.
Ollama — если нужно запустить модель на ноутбуке за пять минут. Ставится одной командой, скачивает модель сам, работает без настройки. Идеально, чтобы пощупать модель или собрать прототип.
А вот в прод его обычно не берут — почему, будет понятно дальше.
vLLM — дефолт для продакшена. Ставится через pip, сразу поднимает сервер с OpenAI-совместимым API, работает на самом широком парке железа: NVIDIA, AMD, Intel, TPU.
Умеет всё, о чём мы говорили: батчинг, квантизацию весов и кэша, кэширование префиксов, спекулятивный декодинг. Здесь же живут все команды и флаги, которые встречались по ходу статьи.
Ещё два аргумента, которые обычно решают. Во-первых, новые модели появляются в vLLM за считанные дни после релиза, а в остальных движках — через недели. Если вы хотите попробовать модель, которая вышла вчера, выбора особо нет. Во-вторых, вокруг него выросла вся экосистема: интеграции с Kubernetes, метрики, готовые операторы, куча публичных разборов чужих проблем.
Если у вас нет конкретной причины взять что-то другое — берите vLLM и не выпендривайтесь.
SGLang — когда у ваших запросов много общего начала. Чат-боты, RAG, агенты — везде, где в каждом запросе повторяется один и тот же системный промпт, инструкции и примеры.
Он переиспользует общие префиксы агрессивнее: доля попаданий в кэш выходит в два-три раза выше, чем у vLLM. На реальных агентских нагрузках это может дать кратную экономию карт. Плюс заметно лучше работает со structured output: если у вас function calling и JSON на горячем пути, у vLLM на этом просаживается пропускная способность, а у SGLang почти нет.
Платите за это тем же, чем vLLM выигрывает: поддержка новых моделей приходит позже, железо в основном NVIDIA, экосистема беднее.
Оговорка про бенчмарки: vLLM и SGLang сейчас отличаются процентов на десять-двадцать, и кто впереди — зависит от формы нагрузки и от того, что каждый из них выкатил в этом квартале. Так что выбирать по одному числу из чужого бенчмарка бессмысленно. Проверяйте на своей корзине запросов, как в третьей главе.
Как это включается
Три метода из прошлой главы — MoE, GQA и размер модели — движок не настраивает: вы выбираете их вместе с моделью. Остальное настраивается флагами, плюс сюда же добавилось кэширование префиксов из первой главы:
| Метод | Ollama | vLLM | SGLang |
|---|---|---|---|
| Квантизация весов | взять уже квантованную модель | взять уже квантованную модель | взять уже квантованную модель |
| Квантизация кэша | OLLAMA_KV_CACHE_TYPE=q8_0 | --kv-cache-dtype fp8 | --kv-cache-dtype fp8_e4m3 |
| Кэширование префиксов | есть, но в пределах слота | --enable-prefix-caching | по умолчанию, глобальное |
| Батч | фиксированный, OLLAMA_NUM_PARALLEL | динамический, по умолчанию | динамический, по умолчанию |
| Спекулятивный декодинг | есть, через Modelfile | --speculative-config | --speculative-algorithm EAGLE |
| FlashAttention | по умолчанию | по умолчанию | по умолчанию |
Обратите внимание: почти всё есть везде. Разница в деталях реализации, и в первую очередь — в батче.
В Ollama память под историю нарезается на фиксированные слоты при запуске сервера, ещё до первого запроса. Поставили четыре слота — четыре кэша выделены сразу, даже если пользователь один. А у vLLM и SGLang память выдаётся по мере надобности, и состав пачки пересматривается на каждом шаге: кто закончил — уходит, освободившееся место сразу занимает следующий.
С префиксами похожая история. В Ollama кэш живёт внутри слота: сервер старается отправить запрос туда, где уже лежит похожее начало, но слотов ограниченное число, и при разнообразных запросах большинство попаданий теряется. У vLLM и SGLang кэш общий для всех запросов сразу — совпадение ищется по всему, что вообще есть в памяти.
С квантизацией весов всё одинаково: взяли уже квантованную модель — движок сам её подхватит. Разница только в том, что vLLM и SGLang умеют ещё и квантовать на лету: берёте обычную модель в fp16, пишете --quantization fp8, и движок ужимает её при загрузке. Удобно, когда готового квантованного варианта под вашу модель никто не выложил.
И общее: названия флагов меняются от версии к версии. Перед тем как копировать из статьи, сверьтесь с документацией своей версии.
Глава 7. Лечим инференс, не трогая железо
Итак, вы прошли весь путь. Подобрали модель, включили все оптимизации из пятой главы, выбрали движок, замерили на своей корзине запросов и посчитали, сколько карт нужно под целевое время ответа.
И получилось 100500 карт.
Сначала расстраиваемся. А потом вспоминаем, что весь наш расчёт вёлся от одного числа — сколько пользователь готов ждать. И это число не спущено свыше, оно зависит от того, как устроен ваш продукт. А продуктовые решения часто оказываются в разы эффективнее любых инженерных.
Стриминг
Самое дешёвое, что вообще можно сделать. Вместо того чтобы дождаться всего ответа и показать его целиком, отдавайте токены по мере генерации — пусть текст ползёт по экрану.
Формально время не изменилось: последний токен придёт ровно тогда же. Но воспринимается это совсем иначе. Без стриминга пользователь пять секунд смотрит на спиннер и думает, что всё сломалось. Со стримингом он через полсекунды уже читает, и к моменту, когда генерация закончится, успеет прочитать половину.
Человек читает примерно 15–20 токенов в секунду. Если модель выдаёт быстрее, пользователь всё равно не заметит разницы — а значит, весь избыток скорости можно конвертировать в батч и сэкономить карты.
Если у вас до сих пор нет стриминга, а вы уже считаете GPU-бюджет — начните отсюда.
Ждать не обязательно молча
Стриминг решает проблему только после первого токена. А до него пользователь всё равно смотрит на пустой экран — и чем длиннее промпт, тем дольше. У агентов ещё хуже: там перед первым токеном может быть поиск по базе, вызов трёх инструментов и пара секунд размышлений.
Тогда работает то же самое, но шире: показывайте, что происходит. Ход рассуждений, какой инструмент сейчас вызывается, что нашлось в поиске, промежуточные результаты. Что угодно, лишь бы экран не был пустым.
Пользователь, который видит «ищу в документации → нашёл три статьи → читаю вторую», готов ждать втрое дольше, чем пользователь, который видит крутящийся кружок.
Просить модель отвечать короче
Вернёмся к формуле из третьей главы: полное время = TTFT + число токенов × ITL. Половина этой формулы — длина ответа, и её вы контролируете напрямую.
Попросили модель отвечать вдвое короче — ответ приходит вдвое быстрее. Совершенно бесплатно, без единой карты. Плюс вы ещё и платите меньше: выходные токены самые дорогие.
Делается это промптом («отвечай кратко, без вступлений»), настройкой максимальной длины или просто выбором формата ответа. Модели по умолчанию любят разводить: повторить вопрос, извиниться, перечислить оговорки, подвести итог. Половину этого пользователь пролистывает.
Отдельная история — рассуждающие модели. Они тратят токены на размышления перед ответом, и это часто в разы больше самого ответа. Если ваши запросы простые, режим рассуждений можно и выключить.
Роутинг
Не все запросы одинаково сложные. «Переформулируй это письмо» и «проанализируй финансовую отчётность за три года» — задачи разного класса, а гоняете вы их через одну и ту же большую модель.
Идея простая: поставить перед моделями классификатор, который раскидывает запросы. Простые уходят на модель поменьше, сложные — на большую. Экономика тут простая: модель в пять раз меньше стоит примерно в пять раз дешевле.
Классификатором может быть что угодно: правила по типу запроса, маленькая модель-судья, эвристика по длине промпта. Не обязательно строить что-то умное — часто хватает разделения по точке входа в продукте, потому что вы и так знаете, откуда пришёл запрос.
Главная сложность не техническая, а организационная: здесь вам нужно научиться замерять качество, чтобы понять, где простая модель справляется. Подробнее про качество почитайте в моей статье.
Пошаговый план
Соберём всё в план. Вот что делать по порядку, если вам нужно понять, сколько GPU потребуется и как сделать это число меньше.
1. Определите, сколько пользователь готов ждать. Из этого числа считается всё остальное. Переведите его в метрики из третьей главы — время до первого токена и время между токенами.
2. Соберите честную корзину запросов. Выгрузите реальные промпты из логов с продовым распределением длин. На синтетике вы померите не свой сервис.
3. Возьмите нормальный движок. Если у вас Ollama в проде или голый transformers — переезжайте на vLLM. Это разница в разы, а не в проценты.
4. Включите бесплатное — до замера, а не после. Квантизация весов в fp8, квантизация кэша в fp8, кэширование префиксов. Три настройки, которые почти не стоят качества. Мерить конфигурацию без них смысла нет: вы получите цифру, по которой всё равно не будете принимать решение.
5. Найдите ёмкость одной реплики. Реплика — это ваша минимальная рабочая единица: одна карта, или четыре, если модель иначе не влезает. Прогоните бенчмарк (например, vllm bench) на своей корзине несколько раз, каждый раз подавая всё больше запросов в секунду (—request-rate). Смотрите p95, а не среднее. В какой-то момент вы вылезете за порог из первого пункта — последнее значение, которое уложилось, и есть ёмкость реплики.
6. Поделите свою нагрузку на эту ёмкость. Прикиньте пиковую нагрузку — сколько запросов в секунду вы ожидаете — и умножьте на 1,5, потому что прикинули плохо. Если одна реплика держит два запроса в секунду, а вам нужно десять, берите пять реплик.
7. Испугались числа — включайте более сложные оптимизации. Спекулятивный декодинг, более агрессивная квантизация, роутинг. Если совсем плохо, попробуйте модель поменьше или MOE. В крайнем случае используйте дистилляцию LLM в модель поменьше.
8. Все еще страшно — чините продуктом. Стриминг, показ промежуточных шагов, более короткие ответы, роутинг простых запросов на модель поменьше. Всё это меняет ваш порог терпения из первого пункта, а карты не стоят ничего. Поменяли — пересчитайте порог и повторите с пятого шага.
Тема непростая, и после такого объёма вопросы обычно остаются. Если что-то не сошлось или хочется обсудить свой случай — пишите мне в телеграм: @seva_batareika.