Почти девять из десяти компаний уже используют AI хотя бы в одной функции. Это данные свежего опроса McKinsey за 2026 год. Казалось бы, победа. Мне можно успокоиться.
Только вот заработали на этом единицы. Тех, у кого на AI приходится 5% EBIT и больше, всего 6%. И за год эта доля не сдвинулась ни на процент. Девять из десяти внедрили. Шесть из ста заработали.
Почему так? Потому что внедряют без стратегии. Давайте внедрим суммаризацию звонков в поддержке. А ещё чат-бота на сайт. А маркетологам генерацию постов, маркетологи же тоже люди. Каждый пилот по отдельности выглядит разумно, на презентации так вообще восторг. Но вместе это россыпь экспериментов, и ни один из них не меняет то, как работает компания.
AI-трансформация — это не лотерея, где вы покупаете двадцать билетиков в надежде, что хоть один выиграет. Это системная работа. Выбираем самые важные функции компании, которые будем перестраивать с помощью искусственного интеллекта. Быстро и дёшево проверяем гипотезы, как именно их перестроить. Масштабируем те, что сработали. И параллельно строим инфраструктуру и растим команду.
А на грабли бессистемного внедрения бизнес уже наступал сорок лет назад, когда в офисы пришли компьютеры. С них и начнём.
Глава 1. На компьютеры сначала тоже наезжали
Парадокс производительности
Угадайте, про что экономист Роберт Солоу сказал в 1987 году, за несколько месяцев до Нобелевской премии: «*** видны везде, кроме статистики производительности».
Про AI-агентов? Нет. Про компьютеры.
К тому моменту американские компании уже не один десяток лет покупали компьютеры. А рост производительности с начала 70-х оставался вялым. Деньги потрачены, а в статистике эффекта нет. Экономисты назвали это парадоксом производительности. Скептики говорили проще: пузырь. Знакомо, правда?
А потом во второй половине 90-х рост производительности в США почти удвоился. Экономисты ФРС посчитали, что примерно две трети этого ускорения дали информационные технологии. Компьютеры всё-таки сработали. Просто с опозданием лет на десять. Почему так долго?
Потому что компьютер относится к особому классу технологий. Экономисты называют их General Purpose Technology, технологии общего назначения. Сокращённо GPT. Иронично.
Такие технологии проникают во все сферы и меняют сам способ работы: паровой двигатель, электричество, компьютер. Теперь, похоже, AI. И у всех одна и та же особенность: сами по себе они приносят мало. Деньги появляются, только когда под технологию перестраивают процессы.
Невидимые инвестиции и J-кривая
В 2002 году Эрик Бриньолфсон с коллегами заметили странную вещь. Фондовый рынок оценивал каждый доллар, который компания вложила в компьютеры, примерно в десять долларов. Как будто компьютеры волшебным образом удесятеряли деньги.
Сам компьютер — только верхушка айсберга. За каждым долларом на железо стояли ещё примерно девять долларов невидимых вложений: софт, обучение людей, перестройка процессов, новая структура принятия решений. Экономисты называют это комплементарными инвестициями. Именно они и делали компьютеры ценными.
Эффект получали не те, кто купил больше всех компьютеров, а те, кто вместе с компьютерами поменял устройство работы. Компании, которые сделали и то и другое, дорожали непропорционально быстро. А купить железо и оставить всё как было — почти бесполезно.
У комплементарных инвестиций есть неприятное свойство: их не видно.
Компания тратит деньги на обучение, переделку процессов, внутренний софт. В отчётности это просто расходы. Нового актива на балансе нет, выручка пока не растёт. Со стороны кажется, что деньги улетают в трубу.
Бриньолфсон, Рок и Сайверсон описали это как J-кривую: сначала компания уходит в минус, потом отдача перекрывает все вложения. Авторы пересчитали статистику США с учётом невидимых инвестиций в софт и железо. К концу 2017 года реальная производительность оказалась почти на 16% выше официальной.
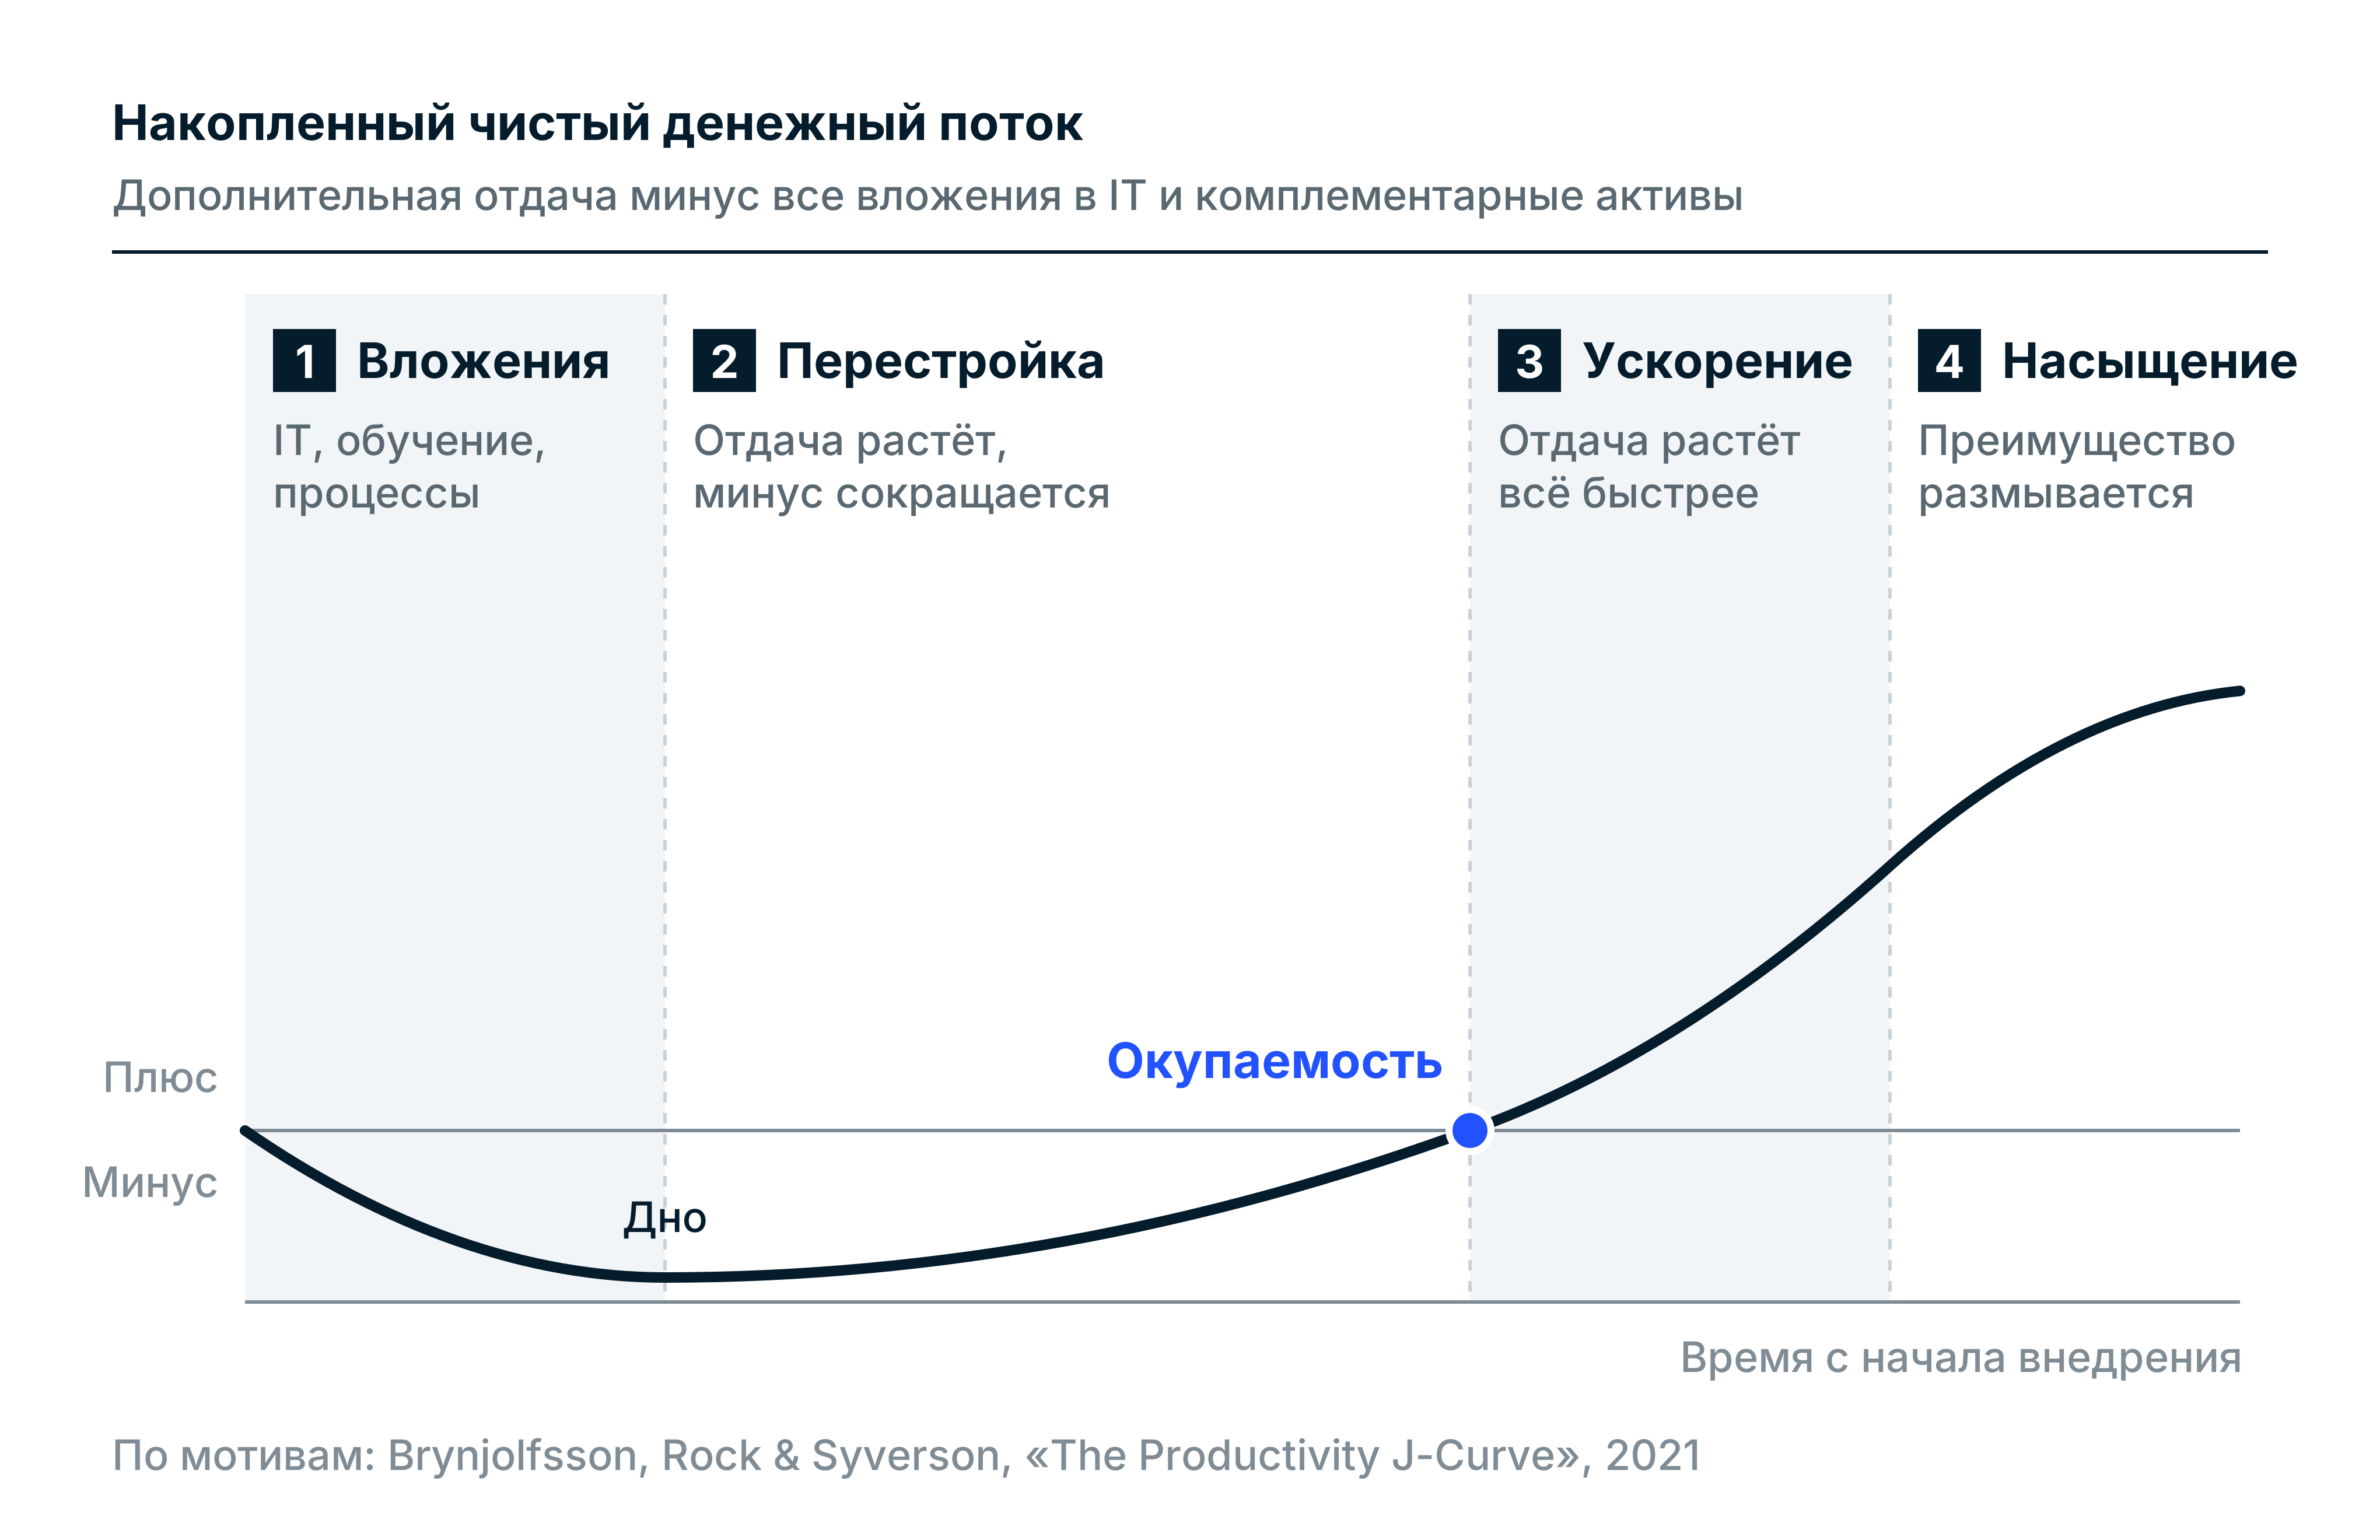
Самое опасное место — дно кривой. Затраты уже есть, отдачи ещё нет, скептики кричат «пузырь!». Именно здесь многие компании сдаются: урезают бюджет, сворачивают проекты и решают, что технология не работает. Ровно в тот момент, когда вложено уже больше всего.
Что это значит для AI
AI пойдёт по той же кривой. Только быстрее: заводы перестраивать не нужно, а часть инфраструктуры AI вообще пишет себе сам.
Но законы те же. И теперь понятно, почему россыпь пилотов не окупается. Пилот — это AI-пыль на старом процессе: технология без комплементарных инвестиций. Компания, которая живёт пилотами, застревает на дне J-кривой навсегда, потому что выбираться оттуда не на чем.
Чтобы пройти кривую, одного терпения мало. Нужно вкладываться в перестройку процессов. Что это значит на практике, разберём в следующей главе.
Глава 2. Как перестраивать процессы с помощью AI
80-е годы, Ford. В отделе расчётов с поставщиками работает больше 500 человек. Руководство решает навести порядок: поставить компьютеры, причесать процессы и сократить штат на 20%. Звучит как пилот мечты.
А потом кто-то из Ford заглядывает в Mazda. И видит, что у японцев тот же отдел состоит из пяти человек. Пяти! Даже с поправкой на размер компании выходило, что людей у Ford раз в пять больше, чем нужно.
Можно было отправить в Японию делегацию изучать корпоративную культуру и утреннюю зарядку. Но в Ford сделали умнее: не стали ускорять старый процесс, а придумали новый. И в итоге сократили штат не на 20%, а на 75%.
Что такое перестройка бизнес-процессов
Сначала посмотрим, как работал процесс в Ford. Отдел закупок отправлял поставщику заказ, а копию — в бухгалтерию. Поставщик отгружал товар и присылал в бухгалтерию счёт. Склад принимал товар и тоже отправлял в бухгалтерию документ о том, что приехало.
В итоге у бухгалтерии на руках три бумажки об одной и той же поставке. Сотрудник сверял их: позиции, количество, цену. Не совпало — начинались расследование и переписка с поставщиком.
Как можно ускорить процесс? Посадить сотрудников за машины, дать им удобную программу для сверки. Сверка честно ускорилась бы. Это и был исходный план на 20%.
А теперь главный вопрос: что нового Ford узнаёт из счёта? Ничего. Зачем вообще сверять бумажки? У Ford уже есть одна бумажка — заказ. Её можно забить в базу того самого компьютера и сверять всё по ней.
Так и сделали. Заказ теперь лежит в общей базе. Товар приезжает на склад, и кладовщик проверяет, есть ли такой заказ и совпадает ли с ним поставка. Совпало — система сама отправляет оплату. Не совпало — товар разворачивают обратно поставщику прямо на складе. Нечего сверять — не нужны сотни сотрудников для сверки. Нет сотрудников для сверки — не нужно сверку ускорять.
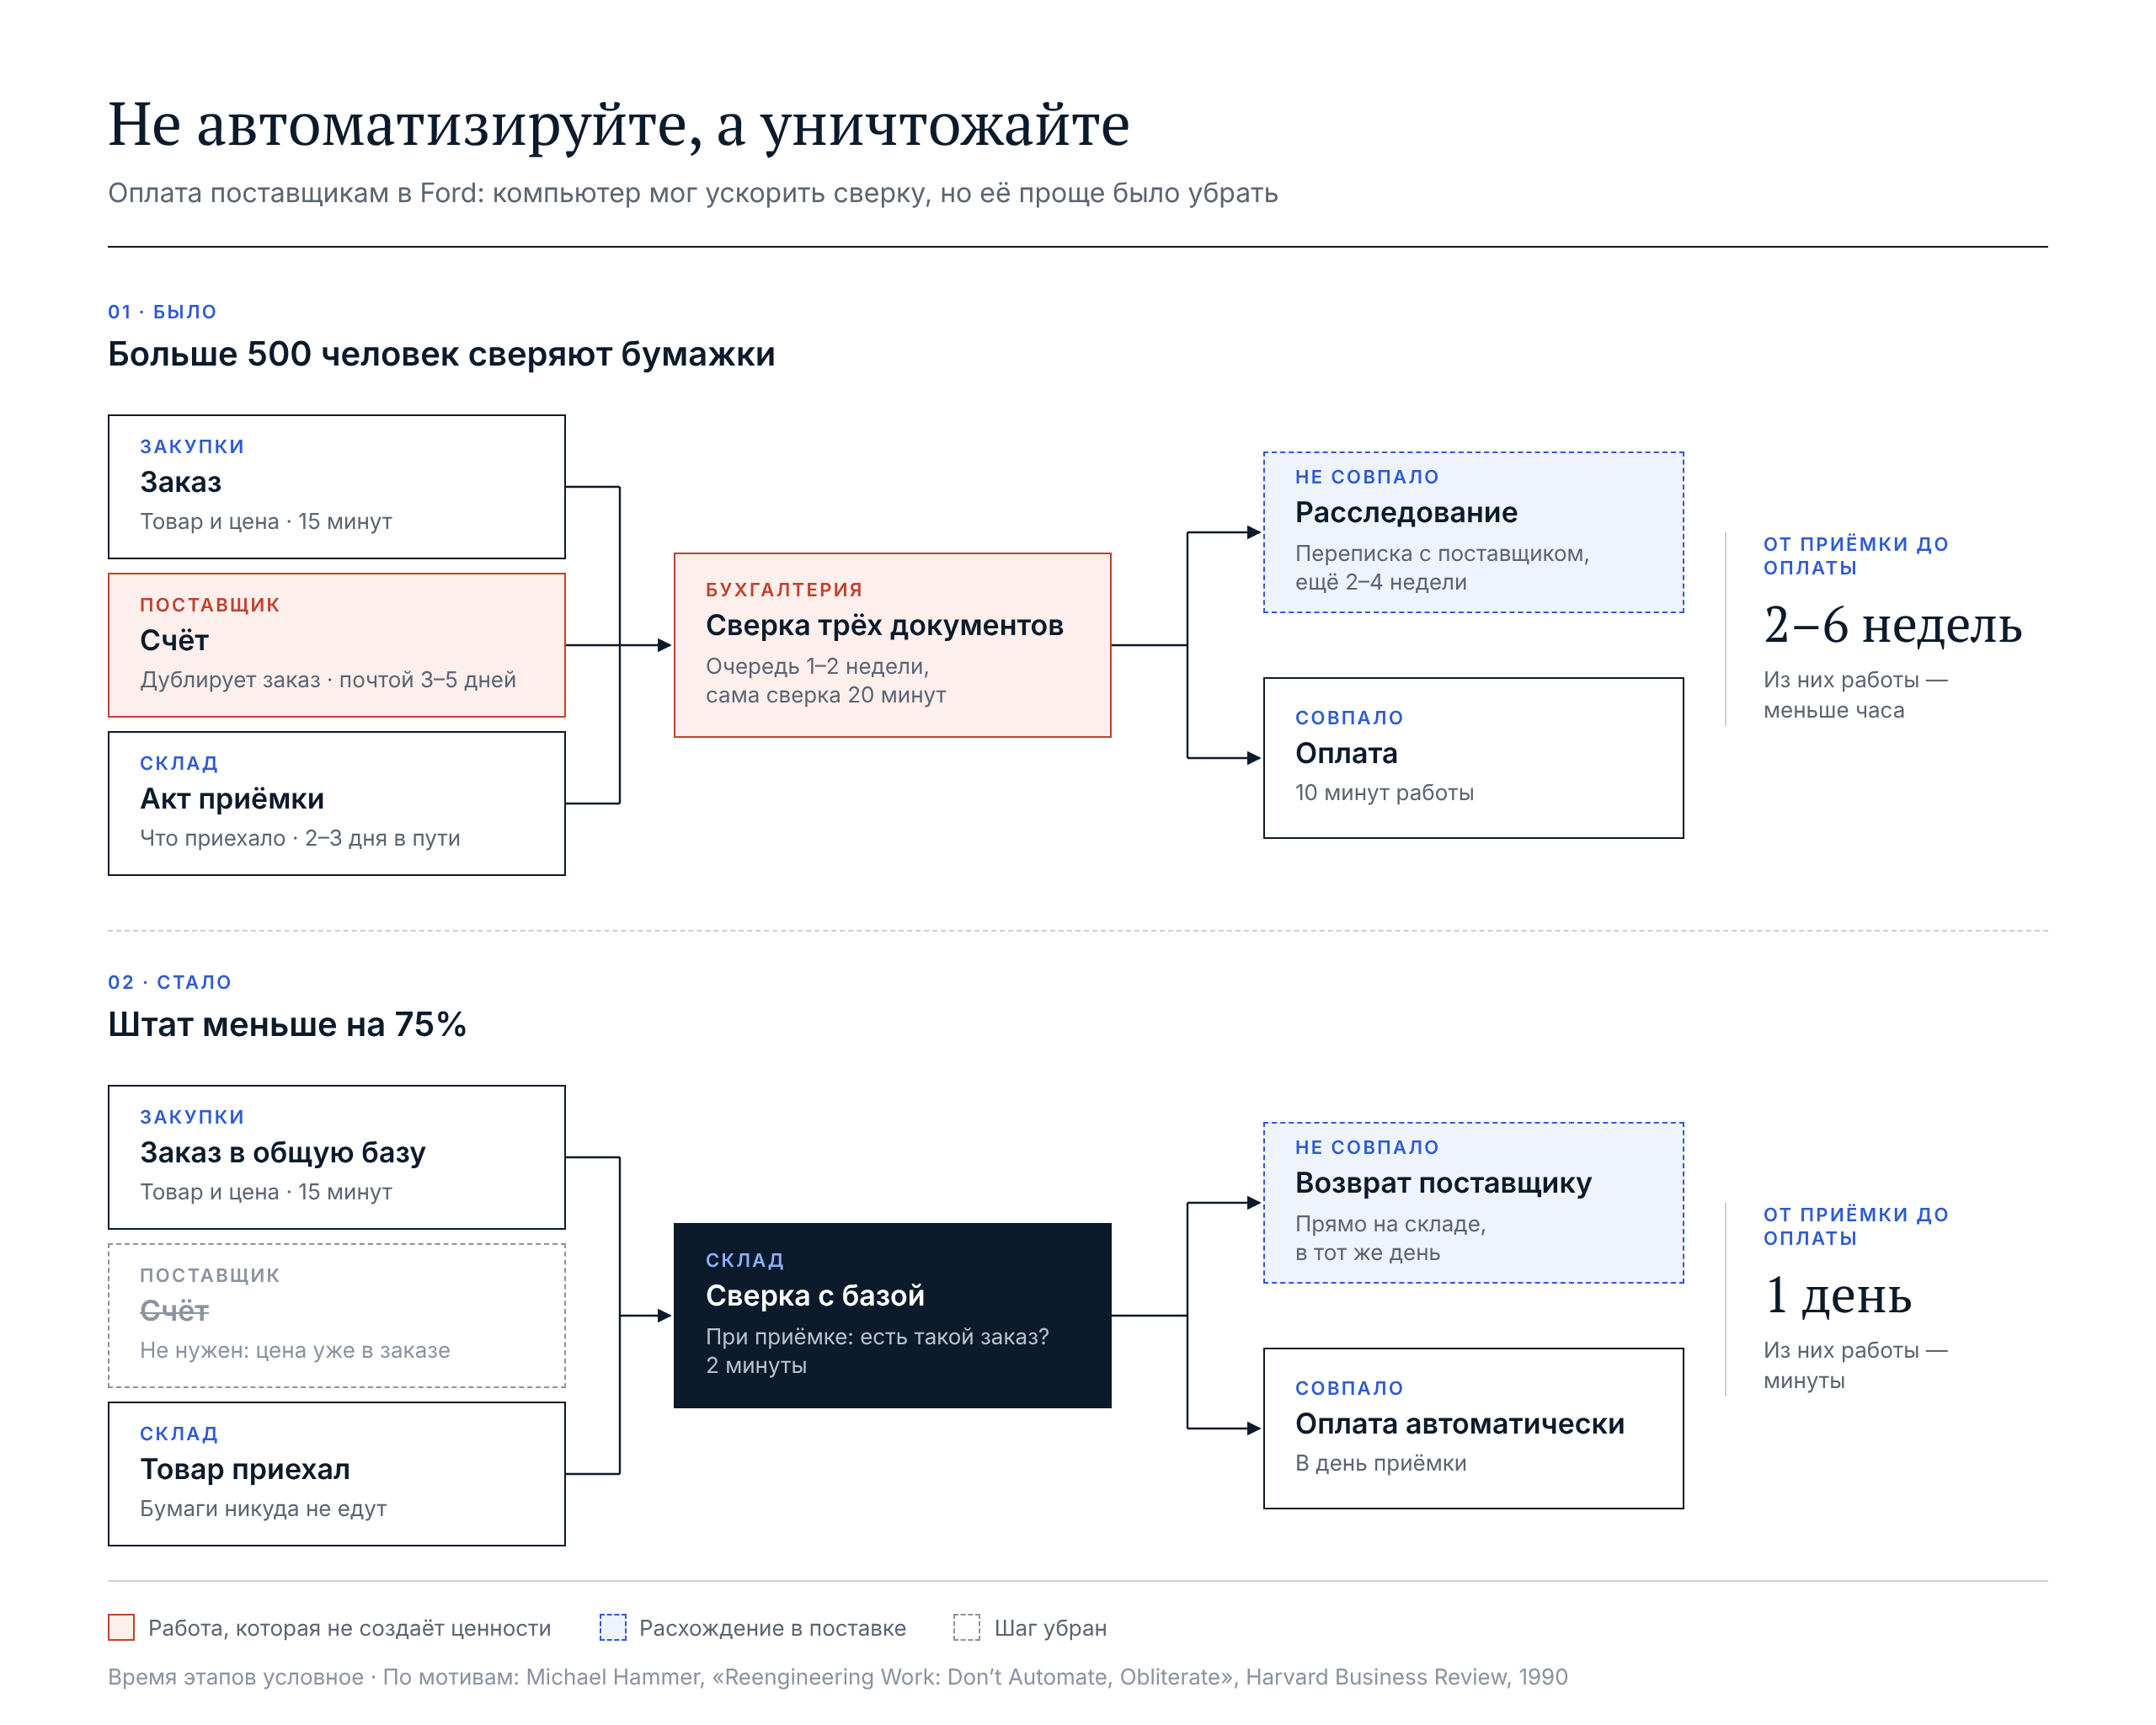
Эту историю в 1990 году рассказал Майкл Хаммер, бывший профессор информатики MIT, в статье для Harvard Business Review. Его главная мысль: компании годами вкладывали в IT и получали разочаровывающий результат, потому что ускоряли компьютерами старые процессы. А эти процессы придуманы до компьютеров, под ограничения, которых больше нет. Ускорять их бессмысленно. Их нужно выкинуть и спроектировать заново.
Кстати, эта статья называлась «Не автоматизируйте, а уничтожайте». С тех пор прошло 36 лет. Вместо компьютеров мы внедряем искусственный интеллект. И нам снова пора переизобретать процессы и уничтожать AI-пилоты.
Переизобретаем процессы в эпоху AI
Разберём три кейса. В каждом посмотрим три версии одного процесса: как он работает с обычным IT, что даёт типичный AI-пилот и как выглядит перестройка.
Начнём с кредитов для среднего бизнеса.
До компьютеров кредитный менеджер рассылал запросы по отделам: отчётность — в кредитный отдел, залог — юристам, проверку клиента — безопасникам. Ждал ответов неделями, сводил всё в кредитный меморандум и отдавал кредитному офицеру. Тот решал, давать или нет.
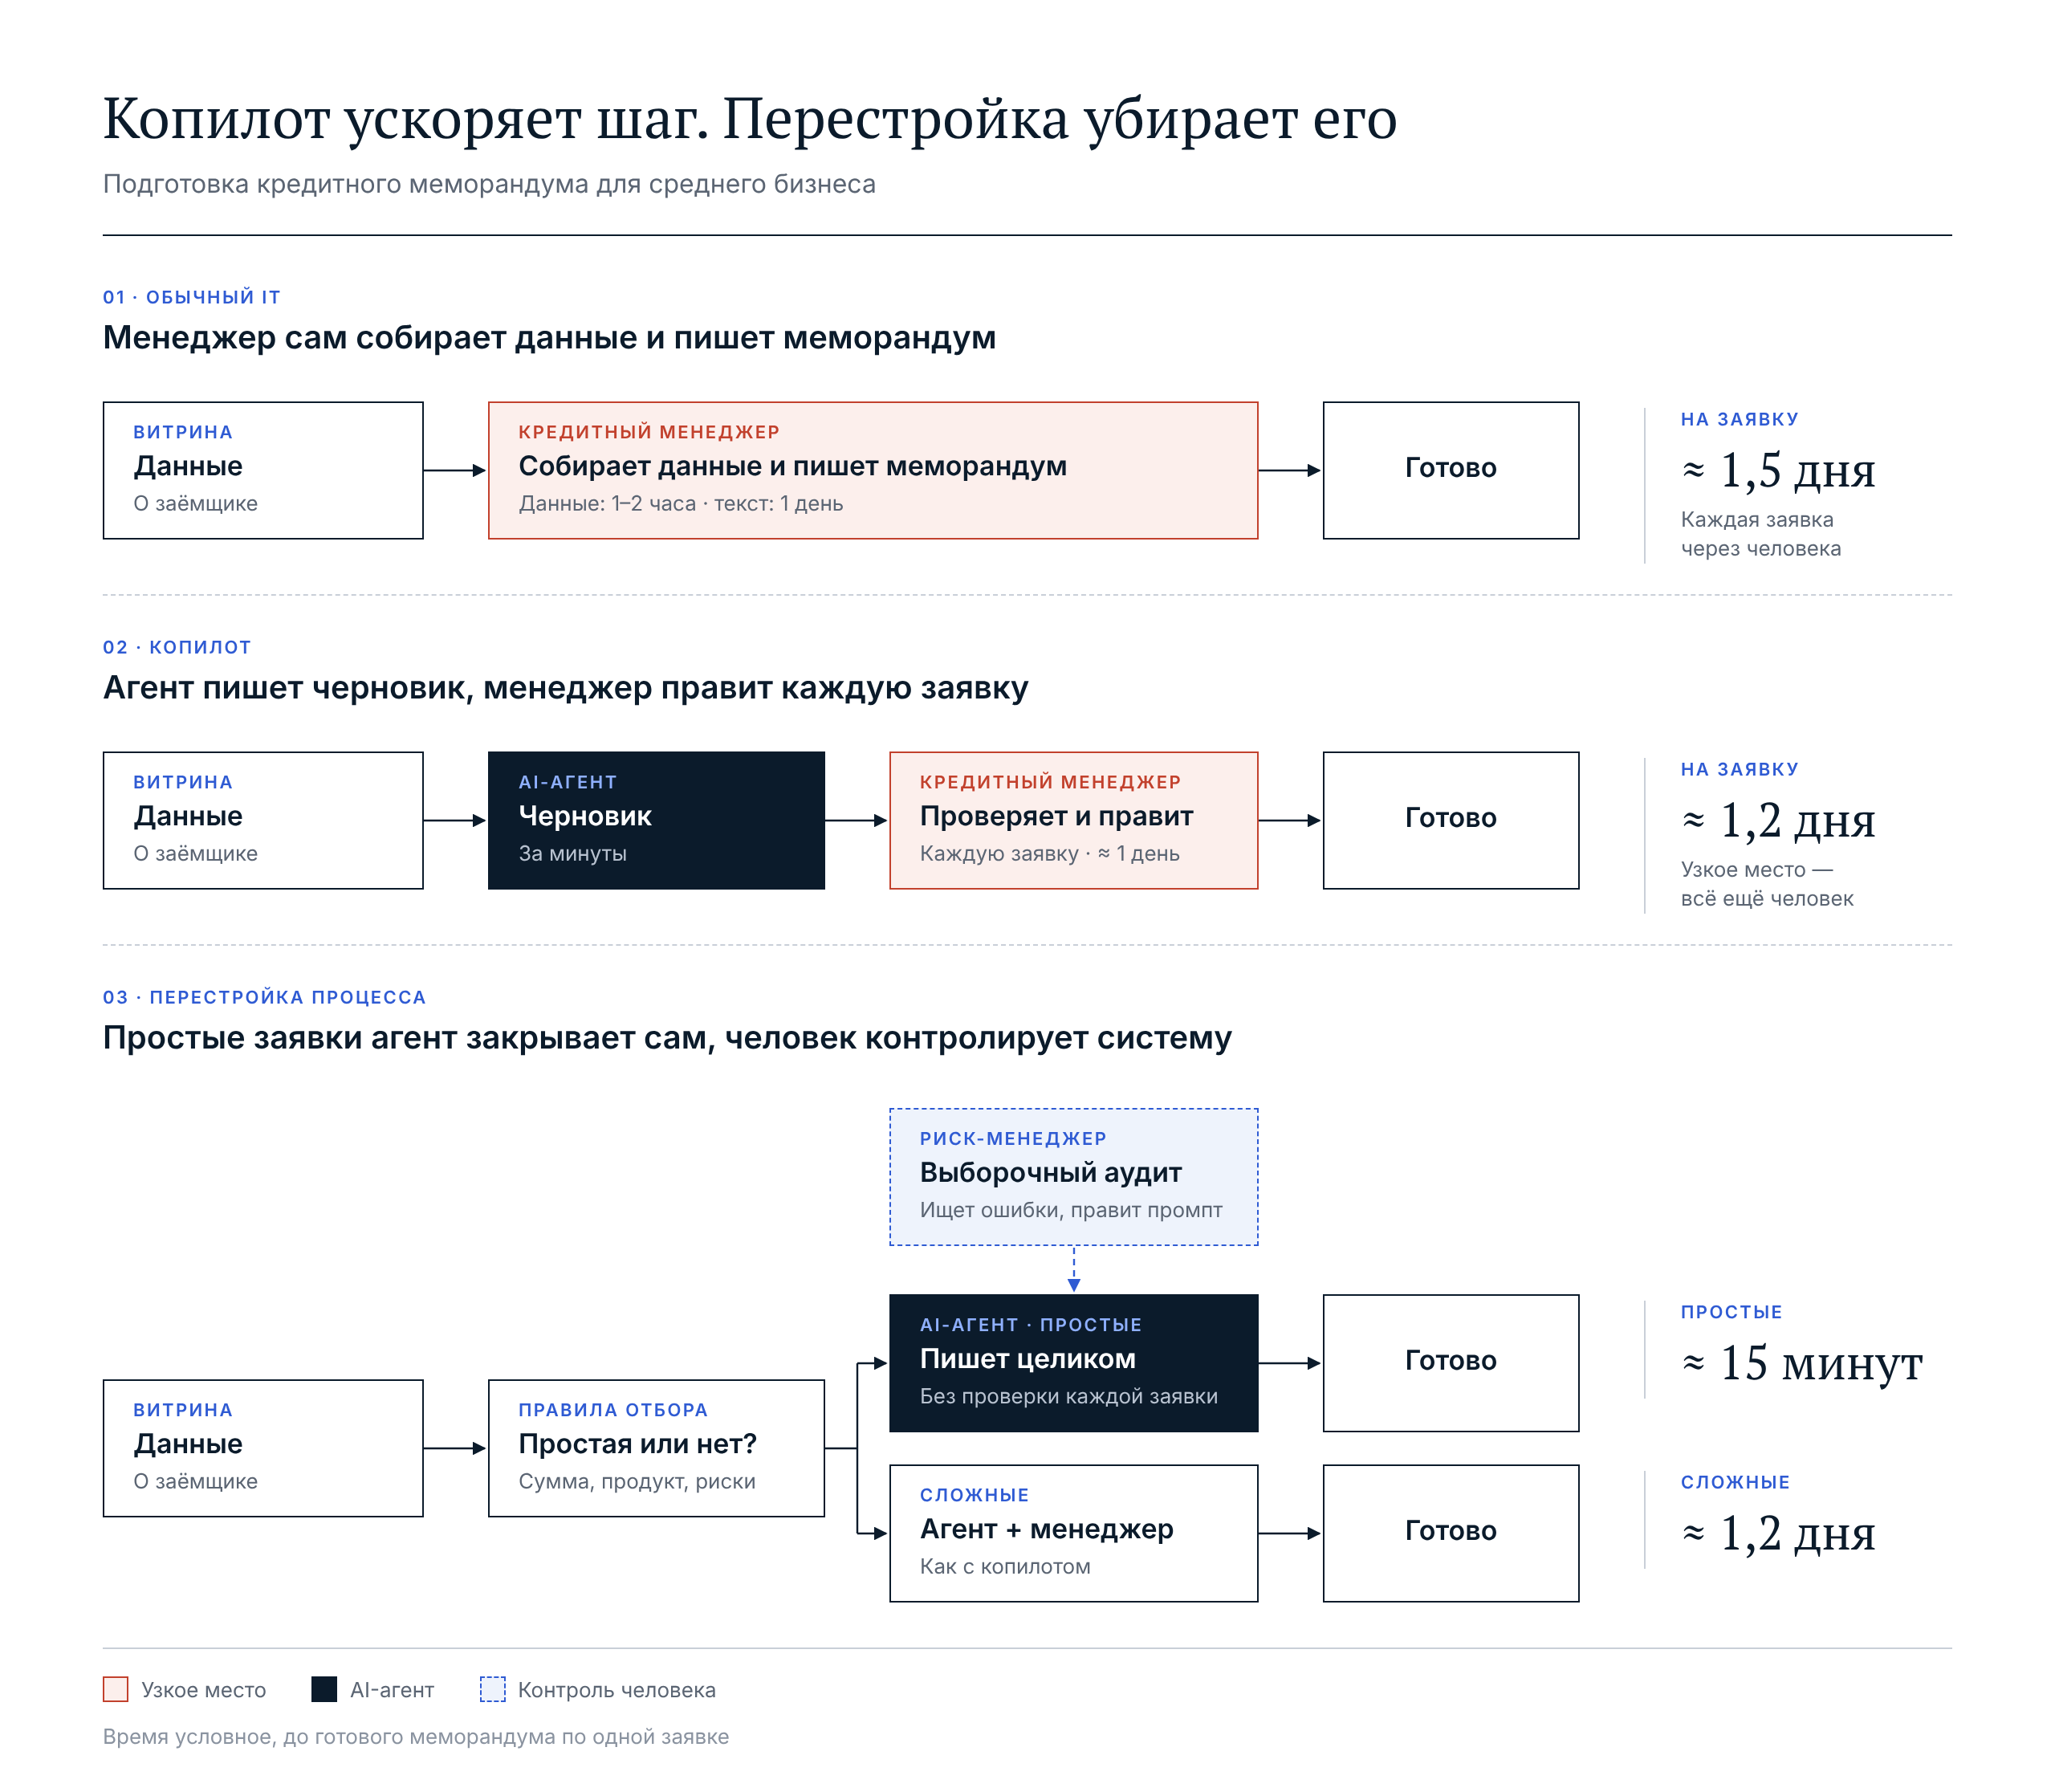
Компьютеры убрали ожидание. Кредитная история, реестры, отчётность теперь лежат в системах, и кредитный менеджер собирает их за час-два. Но дальше всё по-старому: он сам читает документы и пишет меморандум на десятки страниц. День работы на каждую заявку.
Типичный AI-пилот: агент пишет черновик меморандума за минуты, менеджер вычитывает и правит. Шаги те же, просто быстрее. Узким местом остаётся человек, который проверяет каждую заявку. Те самые 20% из плана Ford.
А теперь вопрос: зачем человеку проверять каждую заявку? Большинство заявок похожи друг на друга: типовой продукт, понятный клиент, небольшая сумма. Поэтому процесс перестраивают так. На входе правила отбора по сумме, продукту и рискам делят заявки на простые и сложные. Простые агент проходит целиком: сам собирает данные и пишет меморандум, без проверки человеком. Сложные идут как раньше, агент с менеджером.
Роль человека меняется. Проверять каждую заявку больше не нужно. Риск-менеджер регулярно смотрит выборку меморандумов агента, ищет систематические ошибки и правит промпт и регламенты. Как старший сотрудник, который не делает работу за джуна, а ревьюит её и даёт фидбек.
Меморандум никуда не делся, его по-прежнему требует регламент. Но простая заявка теперь проходит за 15 минут вместо полутора дней. А человек из исполнителя превратился в контролёра.
Теперь обсудим клиентскую поддержку.
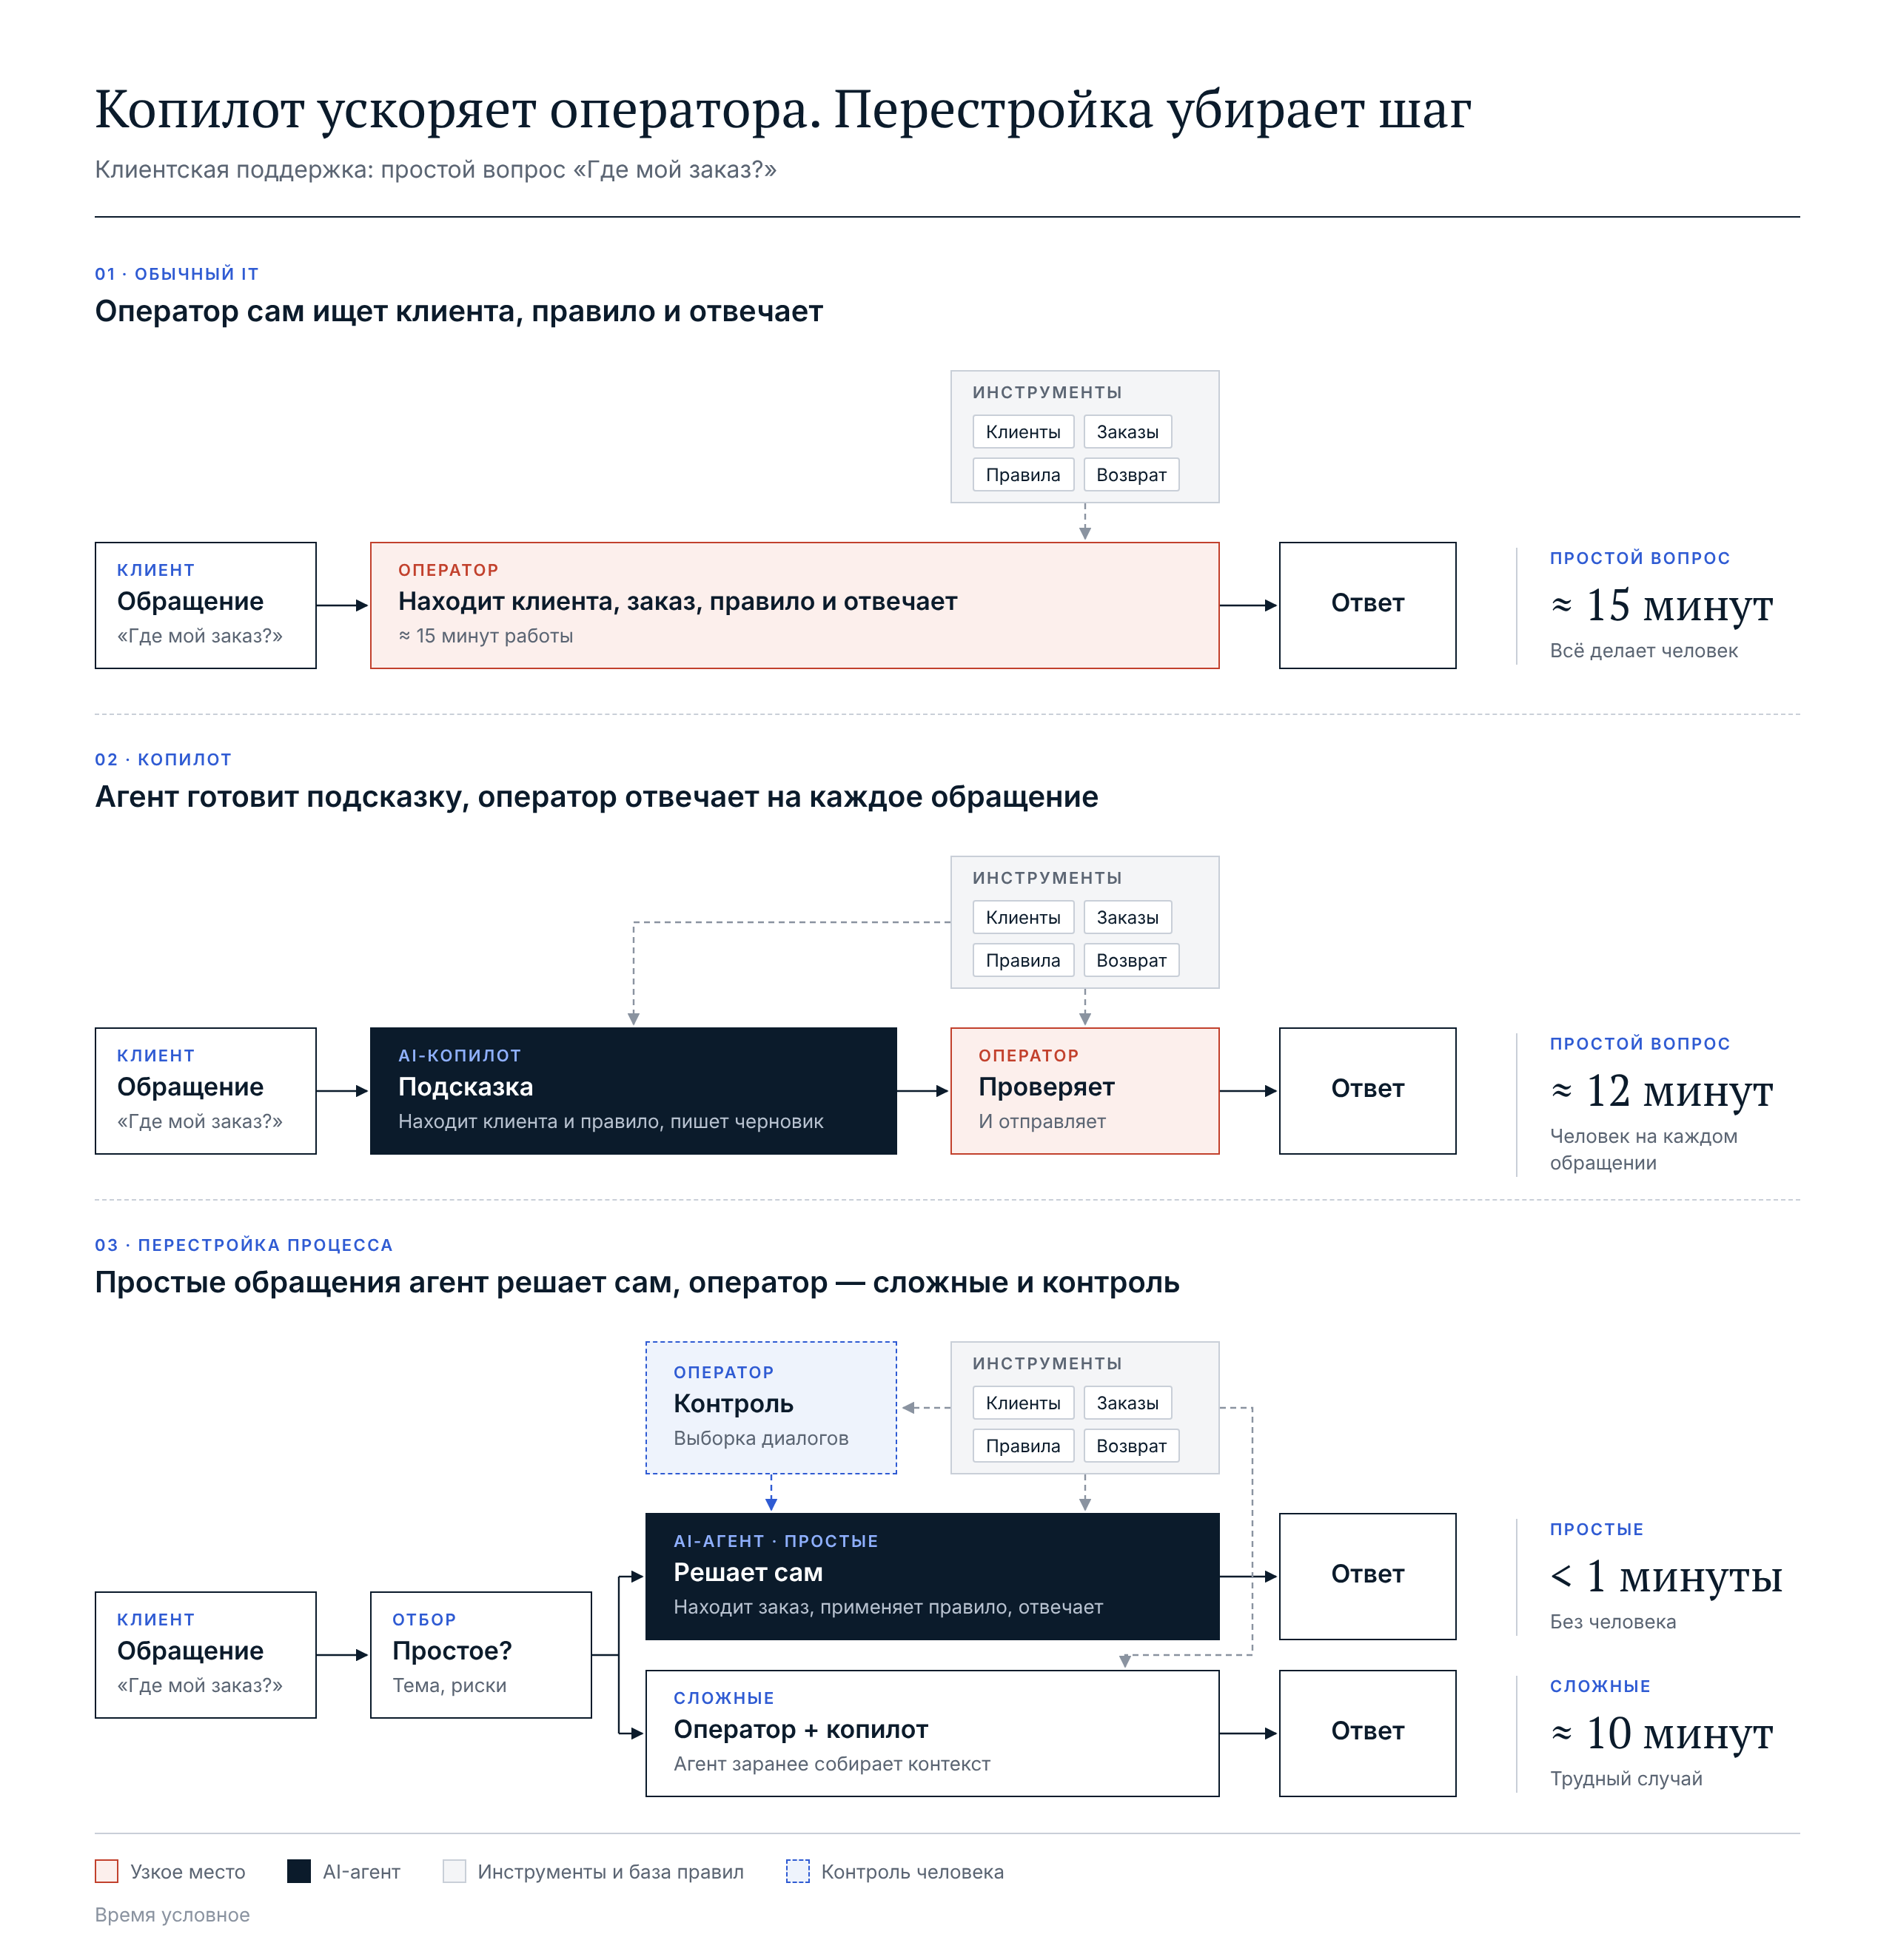
С компьютерами у оператора поддержки появилось всё нужное: база клиентов, история заказов, база знаний с правилами и инструменты, чтобы отменить заказ или вернуть деньги. Клиент пишет «где мой заказ?», оператор сам находит клиента, заказ и нужное правило. Минут пятнадцать на простой вопрос.
Типичный AI-пилот: агент-копилот готовит оператору подсказку. Сам находит клиента и правило, пишет черновик ответа. Оператор читает, перепроверяет и отправляет. Каждое обращение всё так же проходит через человека, поэтому выигрыш скромный. Те же 20%.
Перестройка начинается с того же вопроса: зачем человеку отвечать на каждое обращение? Большинство вопросов в поддержке — типовые: статус заказа, перенос доставки, возврат по понятным правилам. На входе обращения делятся на простые и сложные. Простые агент решает сам: находит клиента, применяет правило, переносит доставку или оформляет возврат и отвечает. Меньше чем за минуту. Сложные уходят оператору, а агент заранее собирает для него контекст.
Роль оператора меняется. Он решает сложные случаи и контролирует агента: регулярно смотрит выборку диалогов, ищет систематические ошибки и правит промпт и базу правил. Тот же старший сотрудник, который ревьюит работу джуна.
Последний кейс: аналитик и продакт-менеджер.
Продакт хочет понять, сколько пользователей дошли до оплаты после нового онбординга. Он пишет аналитику. Аналитик разбирается, что именно спрашивают, лезет в хранилище, пишет SQL, проверяет цифры, собирает табличку и отправляет. Часа два на простой вопрос. А если продакт сформулировал не то, круг повторяется.
Типичный AI-пилот: аналитик работает с копилотом. Тот подсказывает, какие таблицы взять, и пишет черновик запроса. Аналитик перепроверяет и дорабатывает. Полтора часа вместо двух. Каждый вопрос всё так же проходит через аналитика. Примерно те же 20–25%.
Перестройка: простые вопросы агент закрывает сам. Продакт спрашивает напрямую, агент находит нужные таблицы, пишет запрос, считает и отвечает за минуты. Сложные вопросы, где нужно разбираться в логике метрик или в кривых данных, по-прежнему уходят аналитику. А аналитик, как и в прошлых кейсах, переходит на контроль: смотрит выборку ответов агента и правит описания таблиц и метрик.
Но здесь меняется роль не только аналитика, но и продакта. Если продакт выучит базовый SQL, он сможет сам проверить, что агент посчитал то, что нужно, и разобраться в простых ошибках. Тогда большую часть вопросов он закроет без аналитика, а аналитику останутся только по-настоящему сложные вопросы и развитие инструментов, на которых работает агент.
Это частый эффект новых технологий: они заставляют смежные профессии доучиваться. Каждая передача задачи от одного человека другому — это налог на коммуникацию: объяснить, подождать, уточнить, переделать. Когда продакт проверяет агента сам, этот налог исчезает.
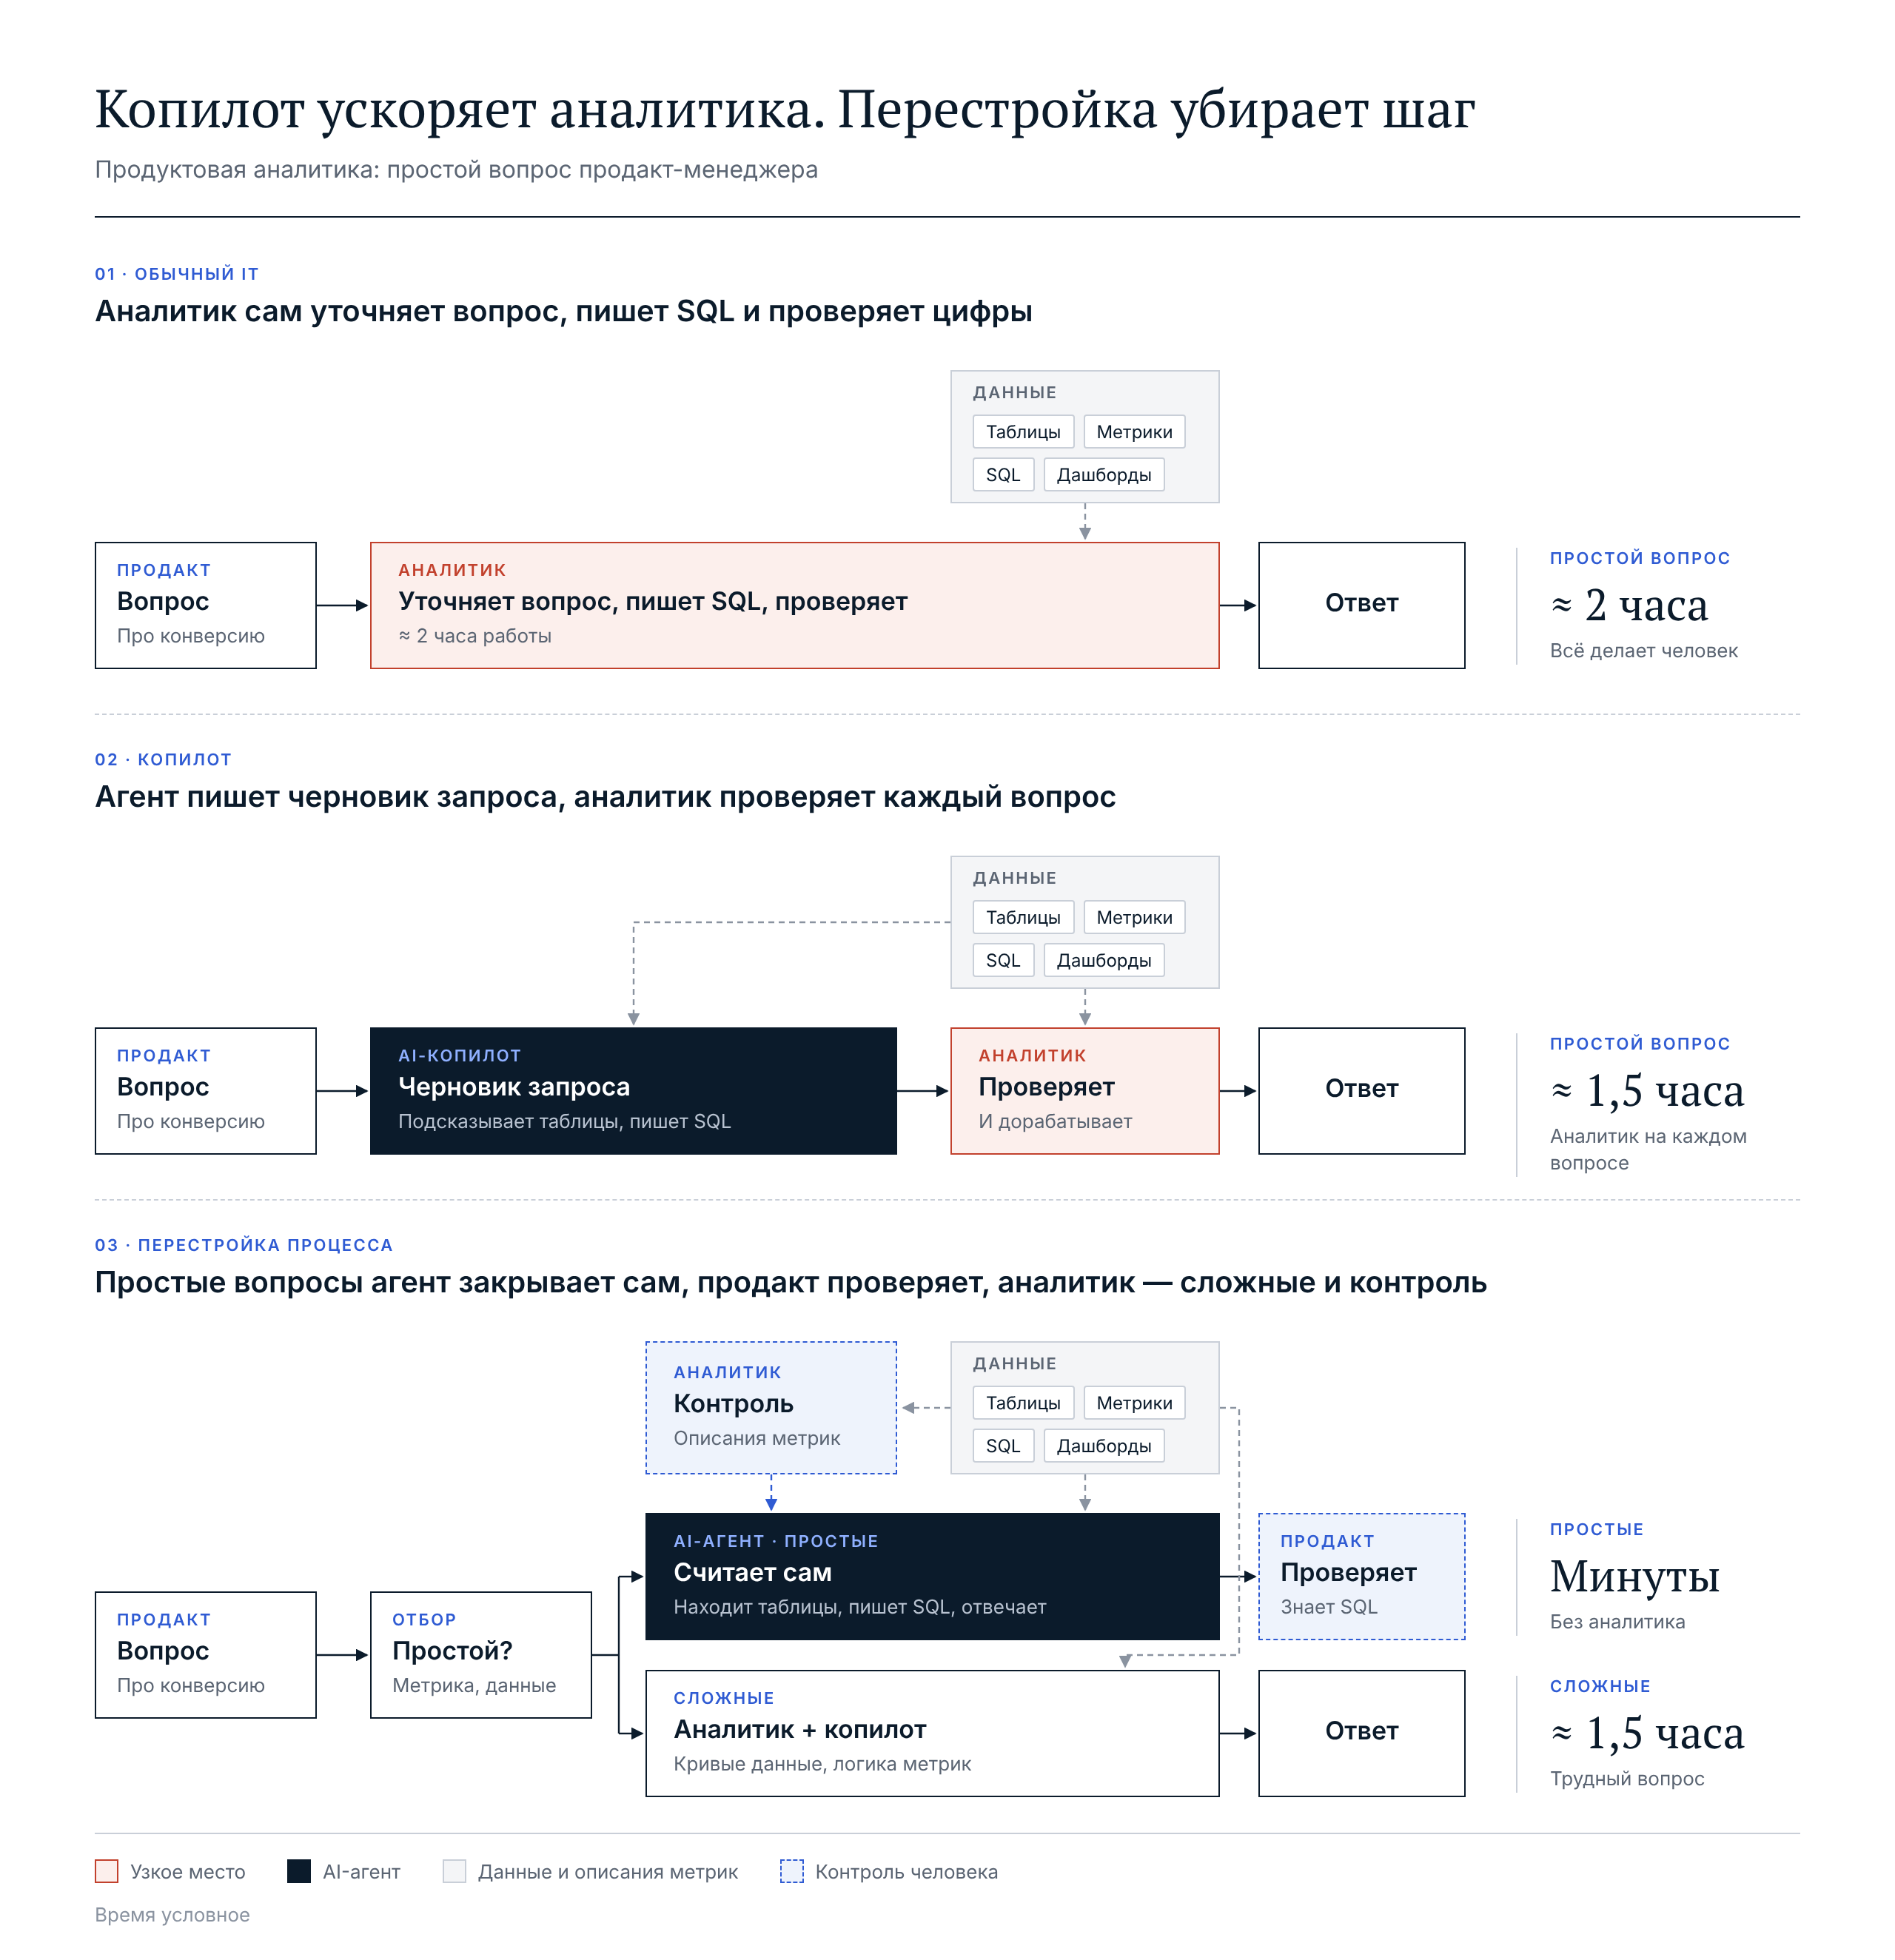
Надеюсь, теперь понятно, как с AI пересобирать процессы. Во всех трёх кейсах одна и та же схема: копилот ускоряет человека на каждом шаге, а перестройка убирает человека из простых случаев и переводит его на контроль. Дальше разберём, как понять, какие процессы вообще стоит пересобирать.
Какие процессы пересобирать
Первый фильтр — бизнес-функция. Смотреть нужно на процессы в ключевых для вашей компании функциях. Тех, что сильнее всего влияют на операционную прибыль.
Поэтому начинайте с вопроса: где у вас деньги? Обычно это такие функции:
- Страхование: андеррайтинг и урегулирование убытков.
- FMCG: маркетинг и цепочка поставок.
- Розничная торговля: управление ассортиментом и товарными запасами.
- Банки: кредитные риски и противодействие мошенничеству.
- IT: разработка продуктов и техническая поддержка.
Второй фильтр — бутылочное горлышко. Внутри ключевой функции нужно найти процесс, который тормозит всю функцию целиком.
Как найти горлышко? Для этого есть простой инструмент — карта потока создания ценности (value stream mapping). Он вырос из производственной системы Toyota. Берёте сквозной процесс от запроса до результата и выписываете все шаги по порядку: кто делает, сколько занимает сама работа и сколько задача ждёт следующего шага. Горлышко видно сразу: это место, где копятся очереди и ожидание.
Возьмём сеть магазинов у дома. Текучка среди кассиров огромная, смены стоят недоукомплектованными, выручка утекает. Рисуем карту найма. Откликов много, но дальше всё стоит: HR тонет в отсмотре резюме. Вот горлышко. Отдаём отсмотр резюме на типовые вакансии агенту, а HR занимается собеседованиями. Найм ускоряется, смены закрываются.
Обратите внимание: HR — не ключевая функция для ритейла. Но здесь именно найм ограничивает продажи. Поэтому горлышко ищите не только внутри ключевой функции, но и на её стыках.
Третий фильтр — агенту отдаётся intelligence-работа. Подробно я разбирал это в статье «Реальная автоматизация». Любая работа состоит из двух типов задач. Intelligence — задачи, где есть понятный процесс: вот вводные, вот регламент, вот критерии хорошего результата. Judgment — экспертные суждения, которые опираются на интуицию и годы практики. Их невозможно описать инструкцией. Агенты хорошо справляются с первыми и плохо со вторыми.
Граница часто проходит внутри одной функции. Возьмём B2B-продажи. Закрыть сложную сделку с крупным клиентом — это judgment: понять, кто реально принимает решение, когда надавить, а когда подождать. Ровно за это хорошим продавцам и платят большие деньги. А вот оценить по понятным правилам (размер компании, отрасль, бюджет, срочность), насколько горячий входящий лид, — это уже intelligence. Такую задачу можно отдать агенту.
То же в разработке. Придумать архитектуру системы, которая выдержит высокие нагрузки, — работа опытного архитектора, чистый judgment. Но если архитектор написал подробную спеку, то написать по ней код — уже intelligence. Именно так опытные разработчики и работают с агентами.
Все примеры из этой главы тоже про intelligence. Кредитный меморандум для типовой заявки: есть кредитная политика и шаблон. Отсмотр резюме на кассира: требования к кандидату понятны и легко записываются. Ответы на типовые вопросы клиентов: есть база правил, где написано, что делать в каждом случае. И даже SQL-запрос для продакта, если есть понятный контракт данных: какие таблицы за что отвечают и как считается каждая метрика.
Простой тест: отдайте агенту ту задачу, которую вы бы отдали начинающему специалисту, снабдив его подробной инструкцией. Эта инструкция потом и станет промптом.
Итак, мы разобрались, как выбрать процесс: он в ключевой функции, тормозит её как горлышко и состоит из intelligence-работы. Теперь давайте наконец обсудим, как подходить к разработке. Об этом следующая глава.
Глава 3. Как управлять AI-разработкой в компании
Как организовать разработку
Разработку нужно вести не по случайным процессам, разбросанным по компании, а по бизнес-функциям. По тем самым ключевым, о которых мы говорили в прошлой главе. Потому что:
- Эффекты складываются. Расшили одно горлышко — работа упирается в следующее. Расшили второе, потом третье. Все они в одной функции, поэтому эффекты не размазываются по компании, а складываются в одну цифру.
- Общая инфраструктура. Доступы к данным, инструменты, интеграции, контур контроля качества — всё это строится один раз. Каждый следующий процесс в функции собирается быстрее и дешевле предыдущего.
- Люди уже заряжены. Руководители функции увидели эффект в своих цифрах и хотят продолжать, их не нужно заново убеждать, что AI вообще работает. А сотрудники, которые получили пользу от агента, сами приходят с идеями, что перестроить дальше.
В каждой функции нужен спонсор из топ-менеджмента, который лично заинтересован в результате. Разработка должна двигать его цифры: KPI, если функция живёт по своим метрикам, или P&L, если у неё свой бюджет.
Без такого спонсора проект завязнет. AI-трансформация постоянно упирается в конфликты: нужны данные другого отдела, люди на разметку, доступ к системе, решение, кто отвечает за ошибки агента. Если руководитель в результате не заинтересован, то всё заглохнет.
Внутри функции вы по рецепту из прошлой главы нашли ключевые процессы. В идеале такие, которые усиливают друг друга. Дальше их можно разрабатывать параллельно.
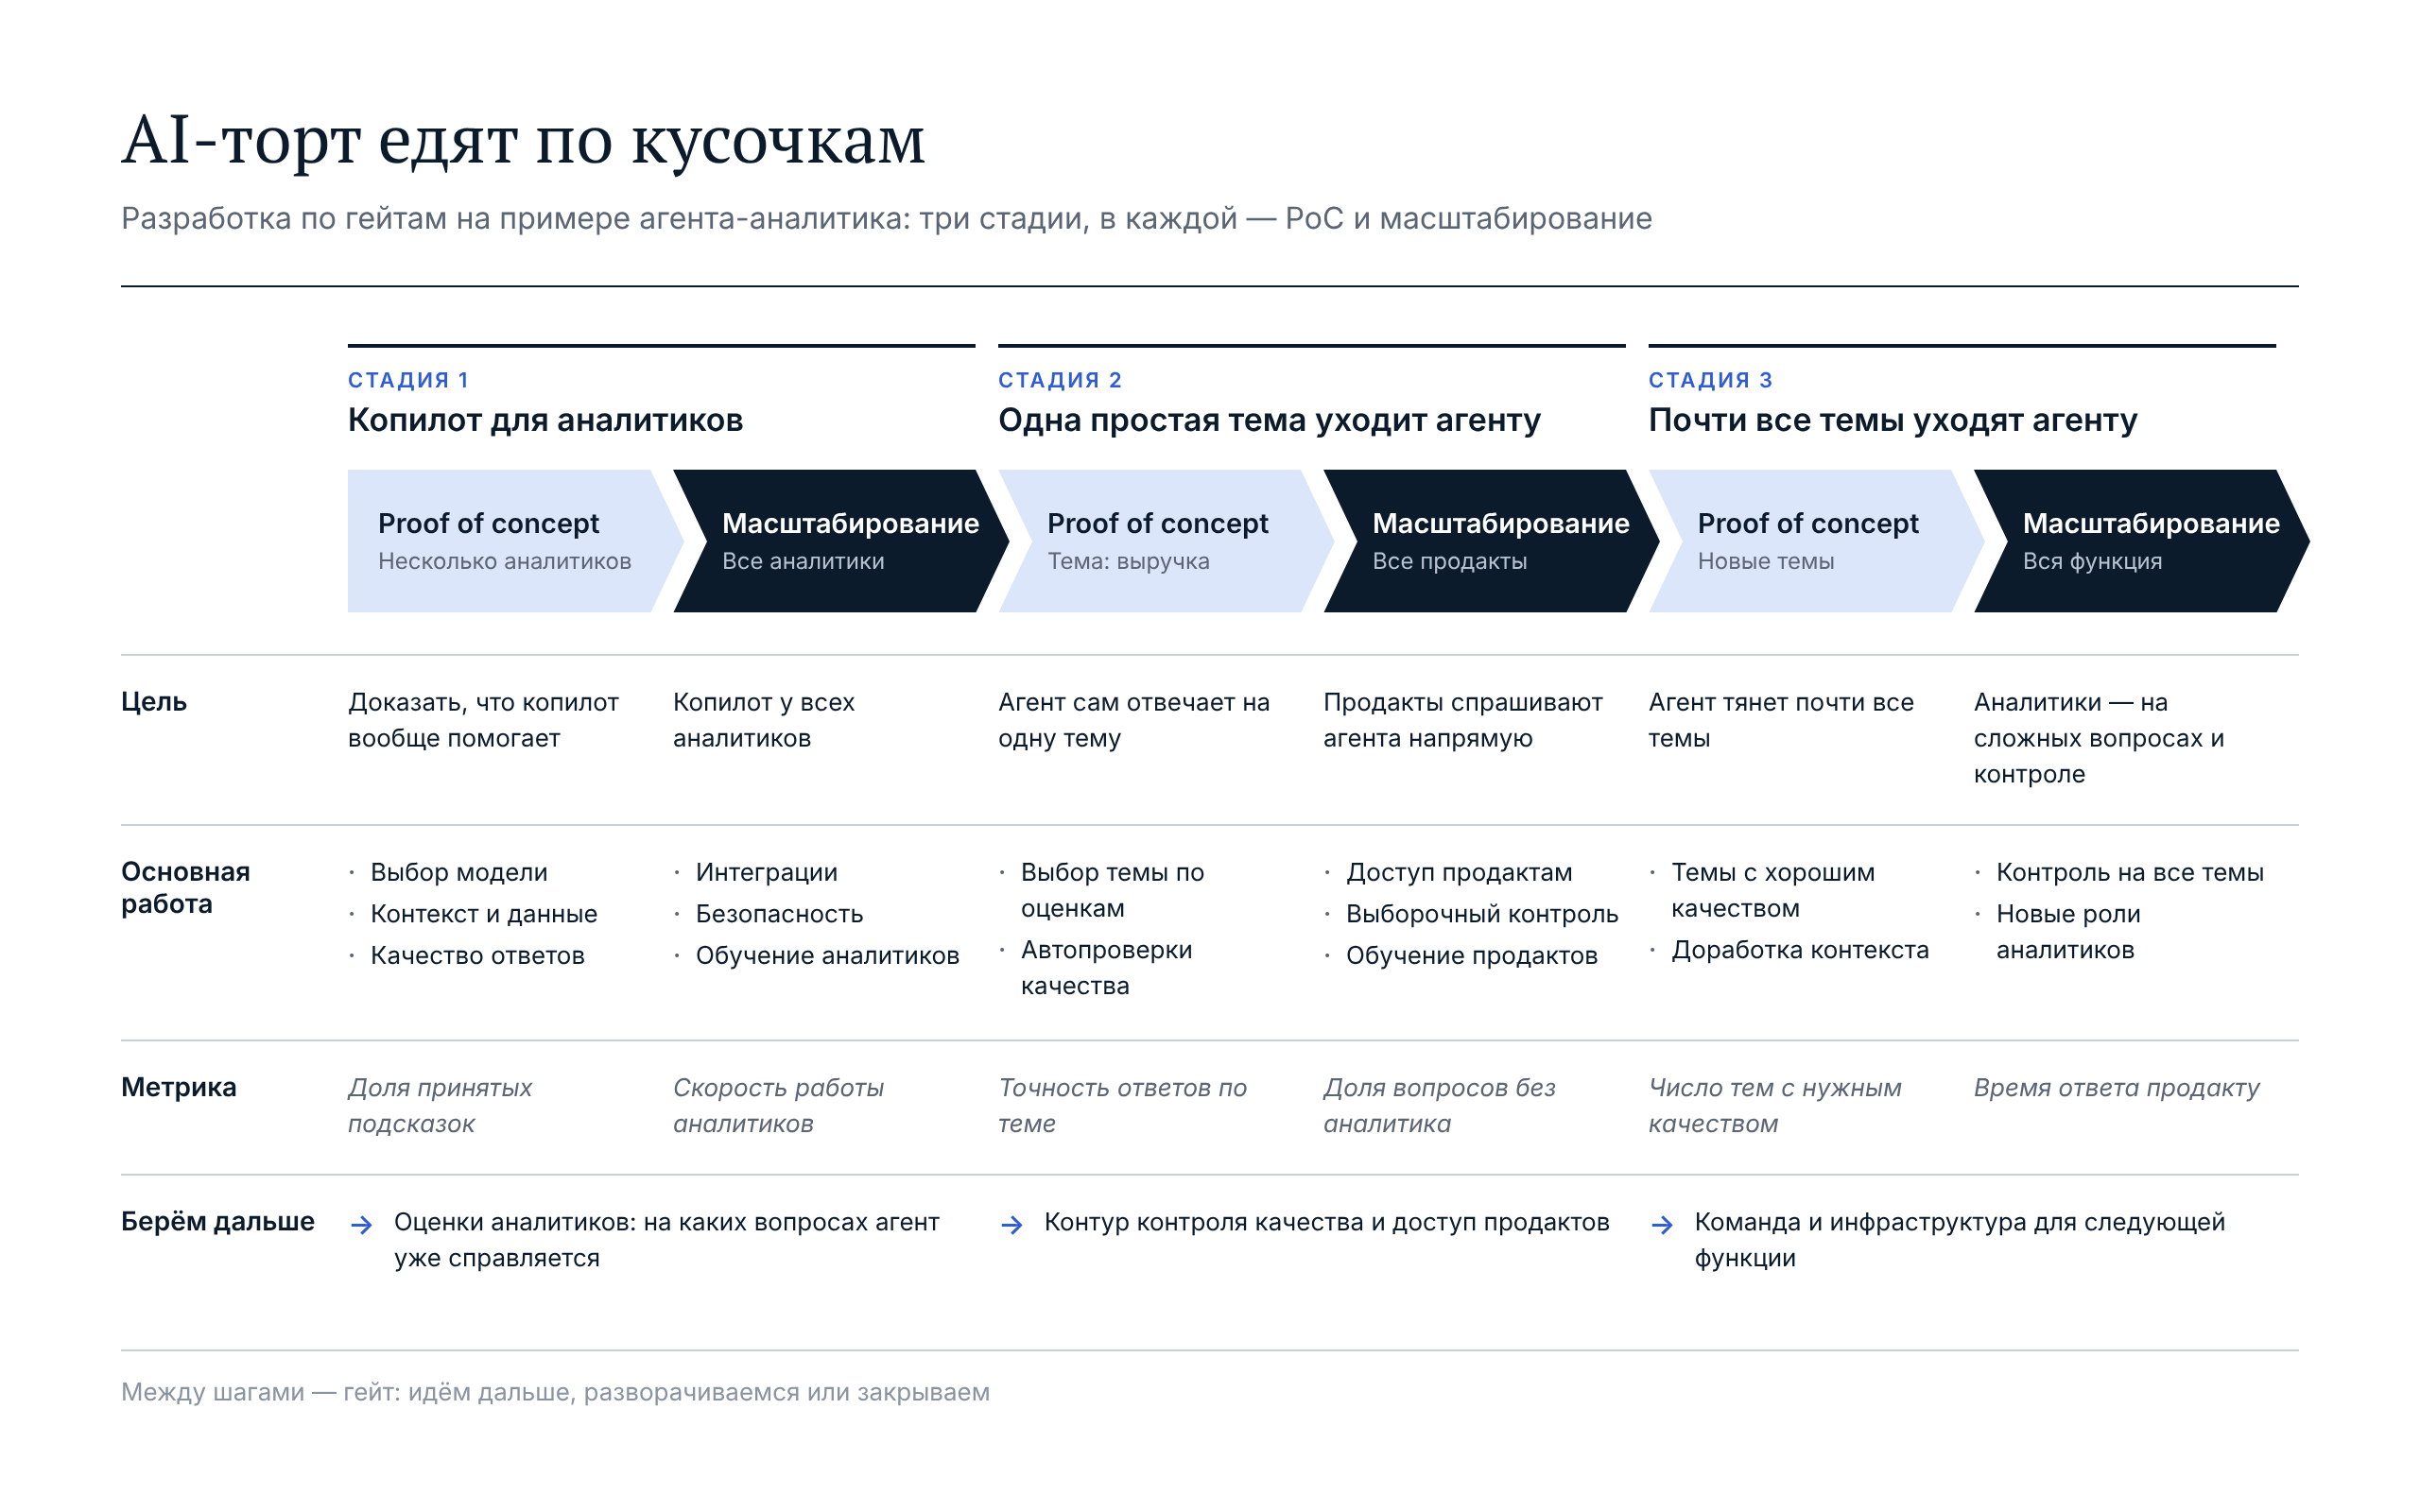
Только не пытайтесь сразу перепроектировать функцию от начала до конца. Это месяцы разработки без единого видимого результата. Команда завязнет, спонсор начнёт сомневаться, а мотивация кончится раньше, чем проект. AI-торт нужно есть по кусочкам.
Поэтому разработка каждого процесса идёт через гейты. Гейт — это точка, где вы смотрите на результат и решаете: идём дальше, разворачиваемся или закрываем. Каждый кусочек должен давать измеримый эффект, а следующий кусочек вы берёте только после того, как прошли гейт.
Сами кусочки — назовём их стадиями — должны идти по возрастанию сложности. Так устроены клинические испытания в фарме. Новое лекарство сначала дают небольшой группе здоровых добровольцев: проверяют, что оно хотя бы безопасно. Потом группе побольше: работает ли вообще. И только потом тысячам пациентов, на что уходит основная часть денег. Каждая фаза дороже предыдущей, и в неё идут, только если прошли прошлую. С AI так же.
Допустим, мы делаем агента-аналитика для продакт-менеджеров из прошлой главы. Стадии могут быть такими.
Стадия 1. Копилот для аналитиков. Агента получают только аналитики, продакты его не трогают. Аналитик видит предложенный запрос и принимает его или правит. Риск минимальный. Зато мы уже меряем, насколько ускорились аналитики. А главное, начинаем копить данные: каждое «ок» или «не ок» от аналитика — это оценка качества агента. Через пару месяцев видно, на каких категориях вопросов агент справляется почти всегда, а на каких постоянно ошибается.
Стадия 2. Одна простая тема уходит агенту. Берём категорию, где по данным первой стадии агент почти не ошибается. Например, вопросы про выручку продуктов. Такие вопросы продакты теперь задают агенту напрямую, а аналитики только выборочно контролируют качество. Снова считаем KPI.
Стадия 3. Почти все темы уходят агенту. Кроме тех, где по накопленным данным всё по-прежнему плохо. Аналитики окончательно переходят на сложные вопросы и контроль.
Посмотрите, как каждая стадия опирается на то, что создала предыдущая. Оценки аналитиков с первой стадии говорят, какую тему отдать агенту на второй. Контроль качества со второй стадии масштабируется на третью. Каждый следующий шаг делать проще и безопаснее.
И на каждой стадии должна расти какая-то метрика. Это не формальность. Джон Коттер в книге «Впереди перемен» назвал быстрые победы одним из ключевых шагов любой трансформации: без видимых результатов люди перестают верить в изменения, и проект тихо умирает.
Далее рассмотрим разработку каждой стадии. В ней есть два шага.
Proof of concept (PoC). Доказываем, что такая штука вообще возможна. Мы же не знаем заранее, получится ли собрать копилот для аналитиков. Поэтому берём нескольких аналитиков и пробуем сделать копилот только для них. Здесь основная работа с AI: выбор модели, контекст, данные, качество ответов. Не получилось — не страшно, мы потратили немного сил.
Масштабирование (scaling). PoC сработал, теперь раскатываем функционал на всех. Здесь работы с AI уже меньше, а больше обычной разработки: интеграции, нагрузка, безопасность, мониторинг. И отдельная большая работа с людьми: объяснить аналитикам, как пользоваться копилотом.
Как сделать PoC? Ведь иногда подобное решение вы делаете первым во всей компании, а может быть, одним из первых во всей индустрии. Когда такое случается, вы попадаете в две страшные буквы — R&D.
Как управлять R&D AI-разработкой
Сложно управлять разработкой, когда не знаешь, получится ли вообще что-то разработать. Даже психологически. Но именно так выглядит R&D: непонятно, реально ли то, что вы задумали. И управлять этим нужно так, чтобы прийти к успеху. Ну или хотя бы не проиграть все деньги в этом казино.
Для R&D нужна небольшая и очень экспертная команда. С явным перекосом в сторону сильных инженеров: им придётся принимать много решений на одной интуиции. И это должны быть люди, которые умеют выдвигать гипотезы и не демотивируются, когда большинство из них проваливается. Команде нужна высокая автономность, а ваша роль — взгляд со стороны, чтобы подсвечивать слепые пятна.
Главный совет: будьте параноиком. У вас в голове должен быть список причин, почему проект провалится. Назовём их блокерами. Планируйте разработку так, чтобы эти причины подтвердились как можно раньше. Ну или, если повезёт, не подтвердились. Логика та же, что в фарме: сначала самые дешёвые проверки, дорогие — в самом конце.
Возьмём наш копилот для аналитиков. Что может пойти не так?
Блокер 1 (самый вероятный): аналитикам он не нужен. Как проверить? Возьмите сотню типовых вопросов от продактов, руками напишите к ним идеальные подсказки и покажите аналитикам. Пользуются? Экономят время? Если нет — разбираемся почему. Не поняли, как поправить, — закрываем проект. Поздравляю, вы уберегли себя от месяцев разработки в никуда.
Блокер 2: человек такие подсказки написать может, а LLM — нет. Берём самую сильную модель на рынке, прогоняем те же вопросы офлайн, сравниваем с подсказками экспертов. Не поняли, в чём фейл, — что делаем? Правильно, закрываем. Сэкономленный рубль — заработанный рубль!
Блокер 3: на топовой модели работает, а на опенсорсе, который можно запускать внутри компании, нет. Думаю, вы поняли.
…и так, пока не соберёте копилот. Чем сильнее менеджер, тем больше причин провала он предусмотрит заранее.
Далеко не всем вообще нужно делать AI R&D. Если на кону не куча денег, просто не лезьте туда. Побудьте немножко ждуном. Подождите, пока компании побольше соберут такие решения, а потом за чашкой чая (ведь чая?) узнайте все их секретики. И сделайте сами — с бюджетом в десять раз меньше. Как именно — в следующем разделе.
Как управлять обычной AI-разработкой
Если R&D вам не нужен, значит, вы уже знаете, как это делать. Либо сами делали что-то похожее. Либо делал кто-то другой и рассказал вам, как. Тогда PoC проходит быстро, и вся стадия идёт как обычная IT-разработка.
Значит, у вас есть план и понятная архитектура. Тогда вам не нужна яростная проверка гипотез. Работа может идти по обычному IT-конвейеру: сделали спеку архитектуры, разбили на задачи, делаете.
Например, для агента-аналитика в простейшей архитектуре (а вы знаете, что простейшая сработает, вы ведь знаете, да?) задачи такие:
- написать промпт для агента;
- сделать тулы для интеграции с хранилищем данных;
- настроить метрики качества, например LLM-as-judge (подробно про это в моей статье про метрики);
- замерить эффект на KPI аналитиков. Например, сколько вопросов закрывает один аналитик в день.
Для такой работы уже не нужны те инженеры, что делали R&D. Когда целевая архитектура ясна, нужны Forward Deployed Engineers (FDE) — инженеры, которые садятся рядом с бизнесом и встраивают агентов в процесс. Подробно я разбирал их в статье «Кто должен внедрять AI в корпорацию».
Главная метрика такой разработки — скорость внедрения. Процессов в функции много, и каждый нужно довести до прода. И тут обычно начинается самое скучное.
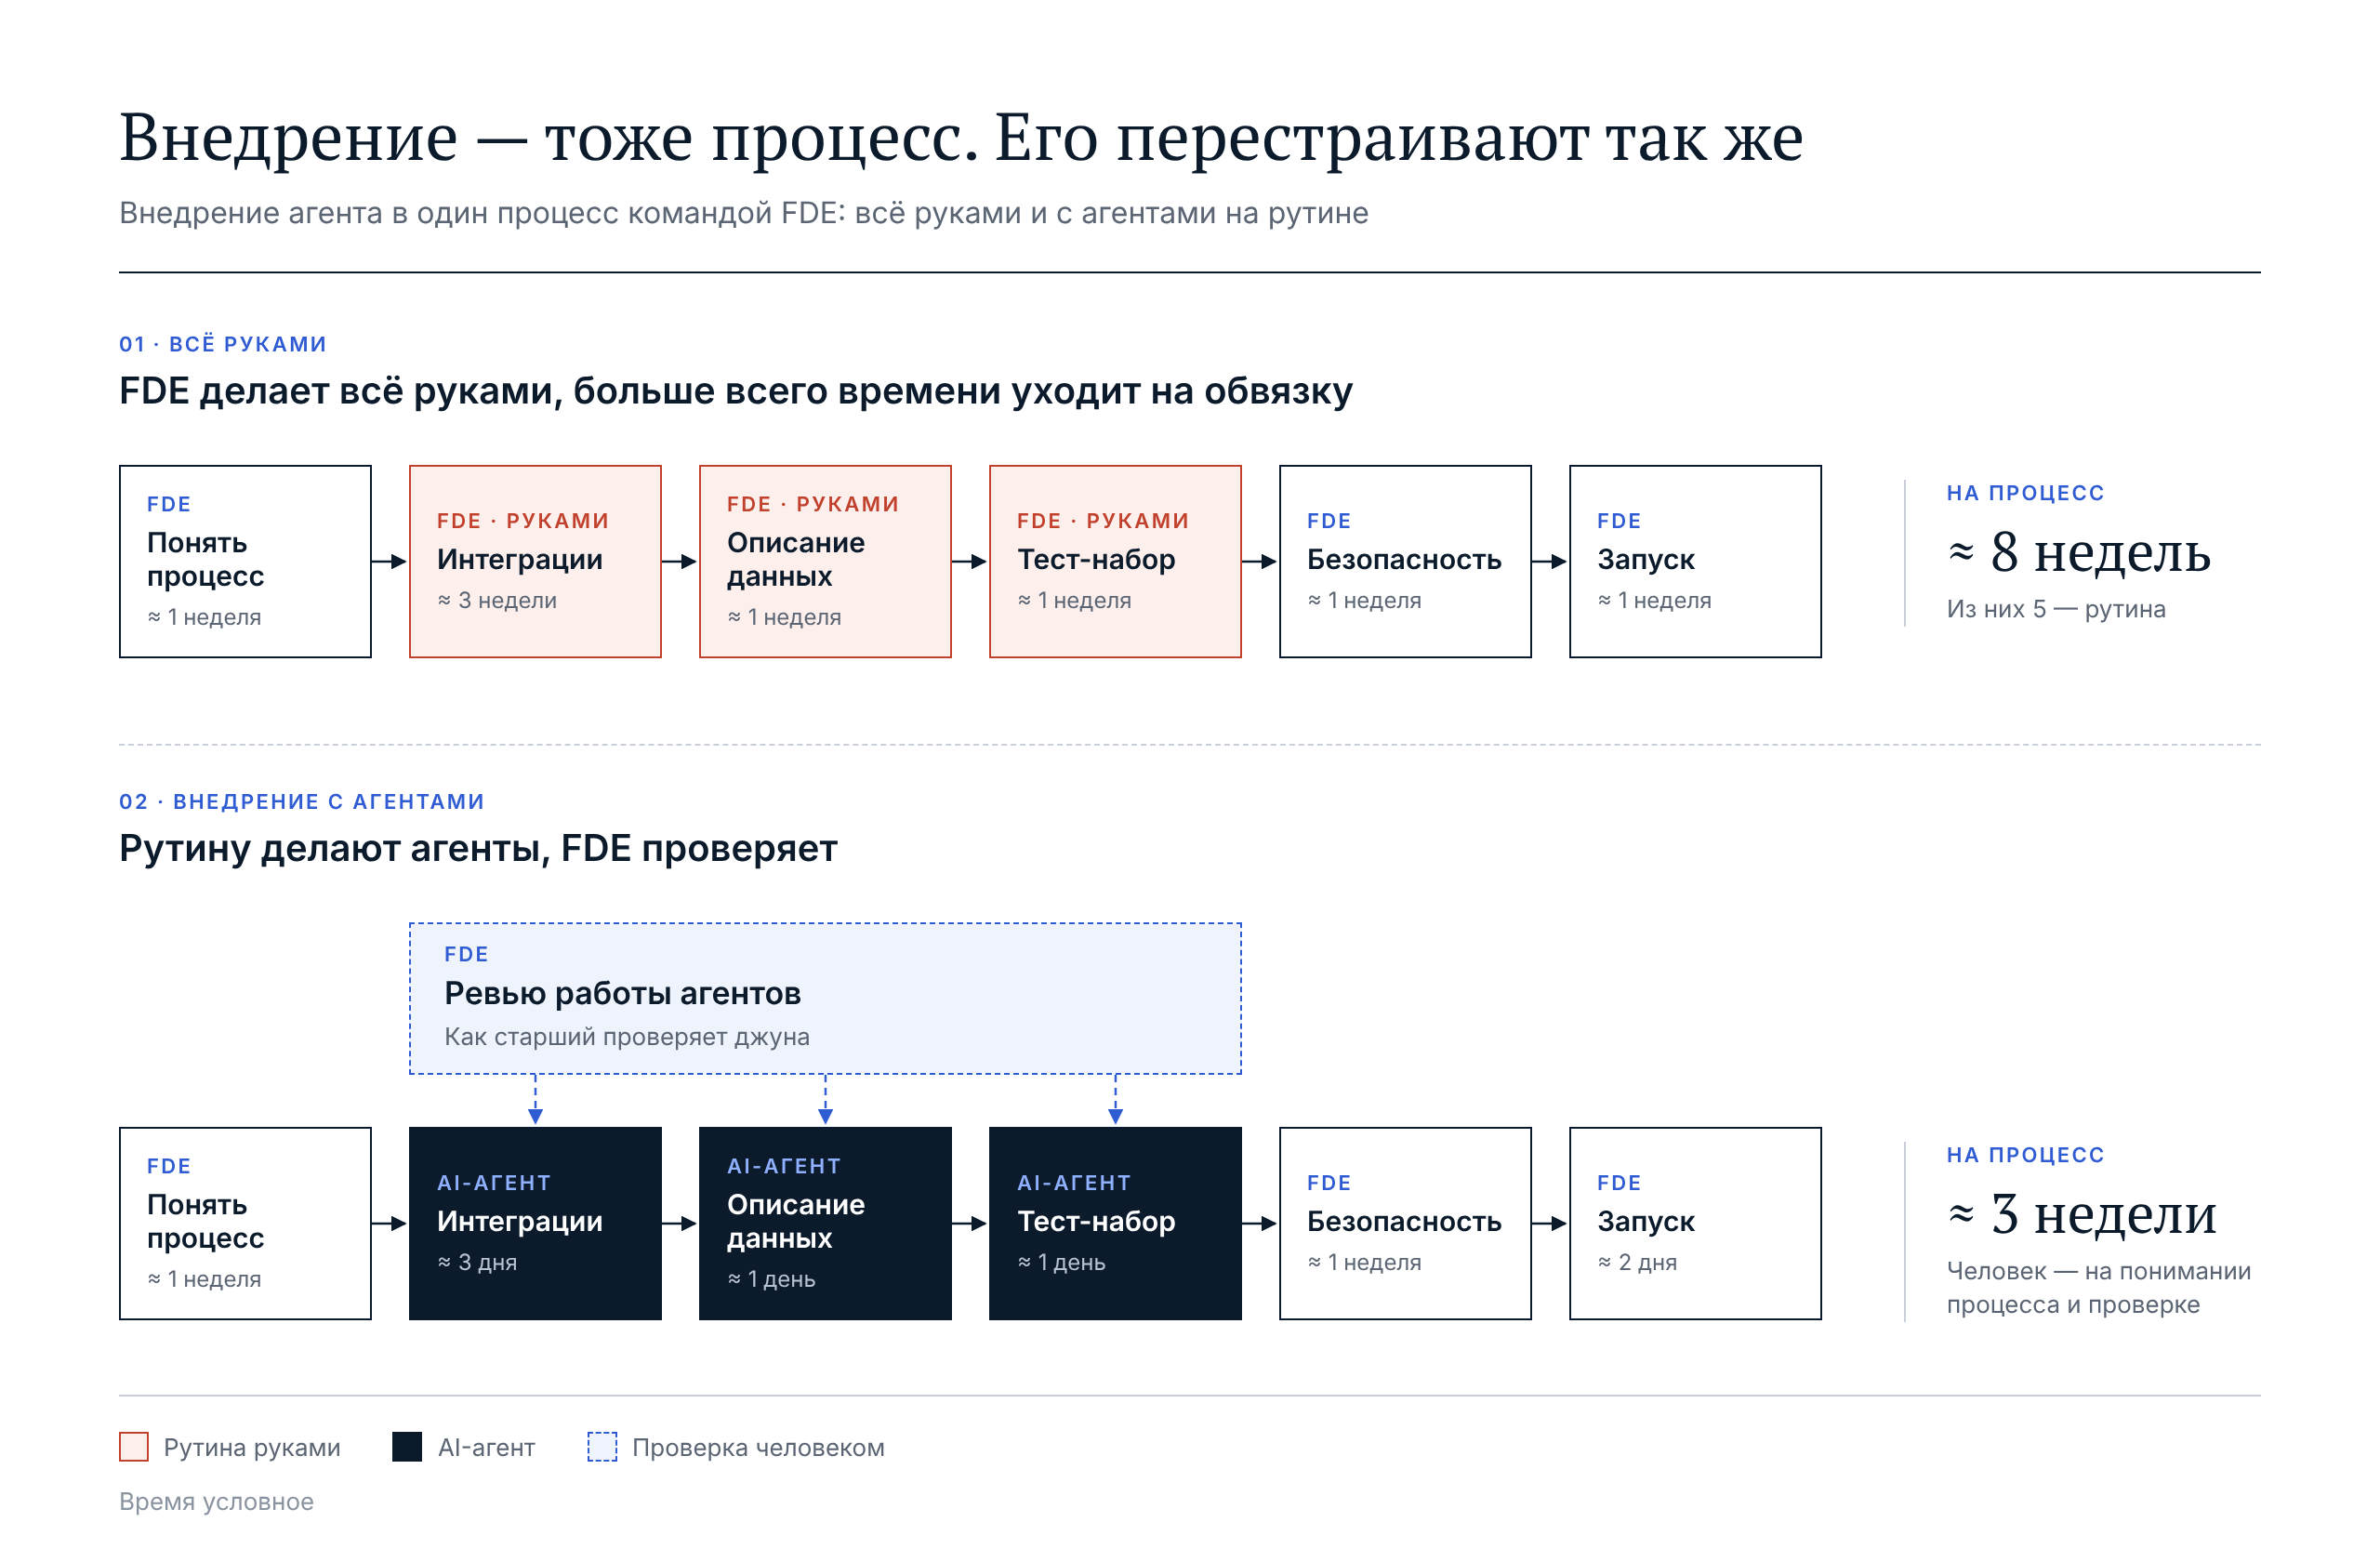
Для каждого нового процесса нужно подключить его системы: CRM, хранилище, базу правил, внутренние API. Каждую интеграцию завернуть в тул. Собрать тестовые примеры для метрик качества. Описать таблицы и метрики, чтобы агент не путал выручку с оборотом. Это много понятной, но ручной работы. И именно здесь застревает внедрение.
Хорошая новость: это та самая intelligence-работа, о которой мы говорили в прошлой главе. У интеграции есть документация API. У тула — понятный шаблон описания. У тестовых примеров — история реальных обращений. Значит, эту рутину можно отдать агентам. Кодовый агент пишет обвязку по документации API. Другой агент по логам собирает тестовый набор.
А FDE в этот момент делает то же, что риск-менеджер и оператор поддержки из прошлой главы: перестаёт делать всё руками и начинает проверять работу агентов. Как старший, который ревьюит джуна.
Получается красивая рекурсия. Мы перестраиваем процессы компании с помощью агентов. А сам процесс внедрения — тоже процесс, и его можно перестроить точно так же: разложить на шаги, найти бутылочное горлышко и отдать рутину агенту. Секрет быстрого внедрения — сначала автоматизировать саму команду внедрения.
После каждой новой AI-разработки у компании накапливаются две вещи: экспертиза команды и платформа, которая позволяет делать следующую разработку быстрее. Об этом поговорим в следующей главе.
Глава 4. Экспертиза и платформа: как ускоряется трансформация
Экспертиза команды
Забудьте идею, что придут вендоры и всё сделают за вас.
В 2012 году онкологический центр MD Anderson в Техасе, один из лучших в мире, запустил проект с IBM Watson. Идея была амбициозная: система должна была помогать врачам подбирать лечение рака на уровне лучших специалистов центра. Технологию делала IBM, интеграции с данными — PwC.
Через четыре с лишним года аудит Техасского университета подвёл итог. Контракт с IBM продлевали 12 раз. Потрачено около 62 миллионов долларов: почти 40 миллионов ушло IBM, больше 21 — PwC. Объём проекта постоянно расползался: начали с одного типа лейкемии, потом добавили ещё пять, потом рак лёгких. А в 2016 году больница сменила систему электронных медкарт, и Watson просто не смог работать с новым форматом данных. Под новую систему его так и не доработали.
Итог: система ни разу не применялась для лечения пациентов. IBM прекратила поддержку пилота, а в 2017 году проект официально заморозили.
Дело не в том, что IBM плохо делает технологии. Просто никто снаружи не знает ваших процессов и данных так, как вы. Вендор приходит, строит по своему пониманию и уходит. А когда процесс меняется, внутри не остаётся людей, которые понимают, как всё это устроено и как это чинить.
Это не значит, что вендоры не нужны. Партнёриться с ними и брать внешнюю техническую экспертизу можно и нужно: это ускоряет внедрение. Опасно другое — отдать им трансформацию целиком.
Поэтому внутри у вас обязательно должен быть свой AI-офис. Он отвечает за трансформацию каждой функции: составляет методику разработки и план по стадиям и гейтам, как в прошлой главе, вместе со спонсором выбирает процессы и следит, чтобы метрики росли. А вот часть технической работы внутри этого плана вполне можно отдать вендорам.
Значит, крайне важно, чтобы внутри росли свои эксперты. Те, кому можно доверить управление этим офисом и кто вместе с лидерами бизнес-функций будет запускать внедрение.
Откуда их брать? Готовых на рынке почти нет, поэтому растить придётся самим. Путей, как и с FDE, два:
- Инженер, который хочет видеть бизнес-результат. Технический фундамент у него уже есть. Нужно научить его разговаривать с бизнесом и отвечать за бизнес-эффект.
- Бизнес-эксперт с инженерным мышлением. Продакт или руководитель процесса с техническим образованием, который понимает, где у функции болит, и хочет сам это вылечить.
Платформа данных и интеграций
Вспомните простой тест из второй главы: агенту стоит отдавать то, что вы отдали бы начинающему специалисту с подробной инструкцией. Но джуну одной инструкции мало. Ему нужно объяснить, кто такой клиент, чем заказ отличается от доставки, что считается просрочкой и какие есть исключения из правил. И дать доступы: в CRM, в систему заказов, к кнопке «оформить возврат».
С агентом то же самое. Ему нужны данные с понятным смыслом и «ручки», через которые он действует во внешнем мире. Эту конструкцию часто называют онтологией данных компании. Удобно разложить её на три слоя.
- Сырые данные. Логи и записи из систем компании как они есть: логи CRM, транзакции, заявки в ERP, тикеты поддержки, записи звонков, PDF-договоры, справочники из 1С.
- Семантический слой. Объекты, их свойства и связи: клиент → заказ → доставка, заёмщик → заявка → договор. И единые определения метрик: что такое «активный клиент» или «просрочка 30+ дней».
- Процедуры. Что можно сделать с объектами и по каким правилам. Например: одобрить заявку, оформить возврат, перенести доставку, обновить статус в CRM. Правила и модели, по которым принимается решение: лимит по сумме, скоринг, правила возврата.
Самое приятное начинается, когда вы движетесь по функции. Возьмём клиентскую поддержку из второй главы.
Первый агент отвечает на вопрос «где мой заказ?». Чтобы его собрать, команда подключает к платформе логи заказов и доставки. Описывает объекты: клиент → заказ → доставка. Делает ручки: найти заказ, перенести доставку, отправить письмо клиенту. Это долго, ведь всё делается с нуля.
Второй агент оформляет возвраты. Клиент, заказ и письмо клиенту уже есть в платформе. Нужно добавить только новое: правила возврата («до 14 дней, без следов использования») и ручку «оформить возврат». Работы уже меньше.
Третий агент разбирает жалобы на качество товара. Ему нужно всё то же самое, плюс связь заказа с поставщиком и действие «эскалировать тикет». Почти всё уже лежит в платформе.
Каждый новый агент переиспользует данные и интеграции, которые принесли предыдущие. Поэтому первый агент в функции внедряется месяцами, а пятый — неделями. Ровно поэтому мы в третьей главе договорились идти по функции, а не по разбросанным процессам.
Платформа AI-инструментов
Вторая часть платформы, после данных и интеграций, — инструменты, на которых собирают и запускают самих агентов. Подробно я разбирал их в статье «Архитектура надёжных AI-агентов», здесь коротко.
- LLM-шлюз (LLM gateway). Единая точка входа ко всем моделям: внешним по API и внутренним. Через него считаются токены и деньги, кешируются запросы, а при падении модели запрос автоматически уходит на запасную.
- Безопасность и guardrails. Проверки, через которые проходит каждое действие агента до исполнения: права доступа к данным, защита от prompt injection, маскирование персональных данных, лимиты на вызовы.
- Observability. Логи каждого шага агента: какую модель вызвал, какой тул, что получил в ответ. Без этого любую ошибку в проде разбирают неделями. Готовые решения есть в опенсорсе, например Langfuse.
- Оценка качества. Общий контур для метрик: тестовые наборы, LLM-as-judge, разметка, дашборды. Чтобы каждая команда не изобретала метрики с нуля.
- Оркестрация и шаблоны агентов. Общий конструктор, в котором собирают агентов, и библиотека готовых шаблонов: копилот, агент с эскалацией на человека, агент с выборочным аудитом.
- Подключение инструментов. Единый способ дать агенту доступ к ручкам из платформы данных, например через MCP. Тул, сделанный для одного агента, сразу доступен остальным.
- Инференс. Если модели работают внутри компании — общий сервис с нормальной оптимизацией, а не отдельная видеокарта под каждый проект. Про то, как его считать, у меня есть отдельная статья.
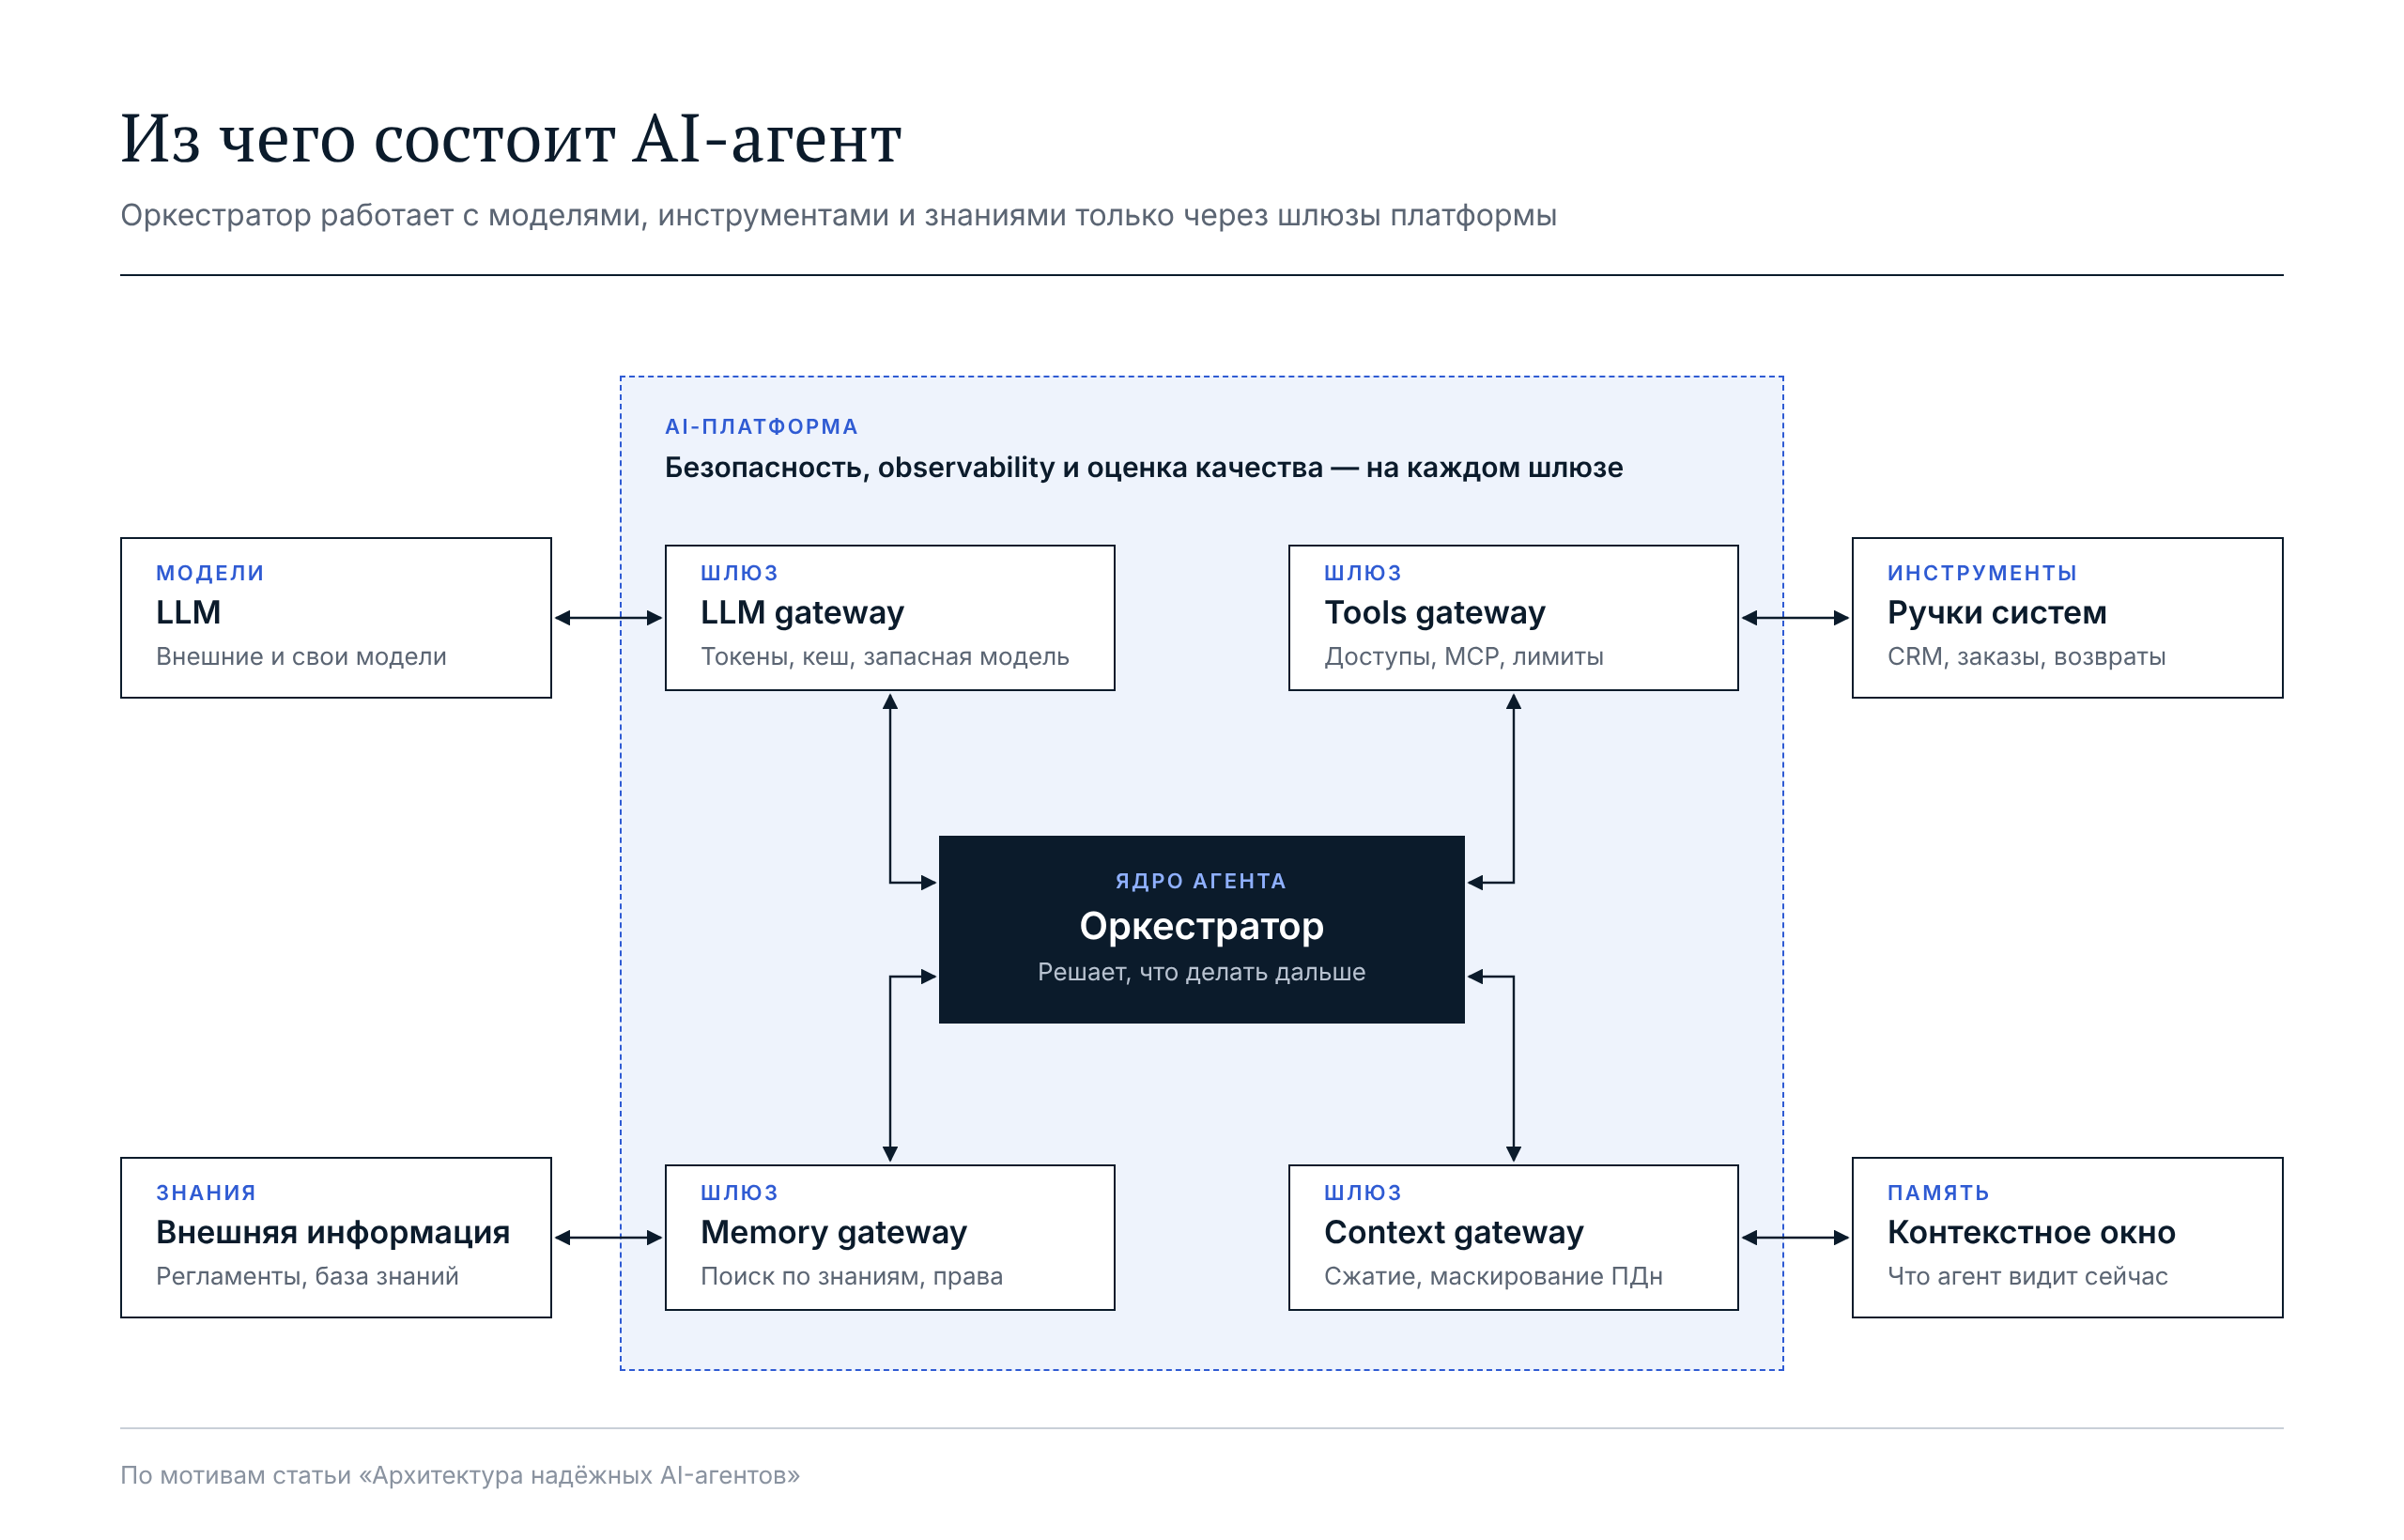
Принцип тот же, что с данными. Каждый следующий агент берёт готовое и занимается своим процессом, а не очередной реализацией логирования.
Но тут важно не перестараться. Не пытайтесь строить платформу на первых кейсах. Если первый агент должен заодно оплатить LLM-шлюз, observability, контур качества и конструктор агентов, его ROI уйдёт в минус. А спонсор, который ждал роста своих метрик через полгода, увидит только счёт за инфраструктуру и расстроится, что он один оплачивает весь банкет.
Поэтому первые кейсы спокойно делайте без платформы. А вот после нескольких успешных инициатив платформу нужно выделять в отдельный трек разработки. И считать ему ROI отдельно. Для этого у вас уже всё есть: вы знаете, сколько принесли первые агенты. Внедрение шло год, а с платформой займёт полгода — значит, эффект придёт на полгода раньше. Это уже можно посчитать в деньгах.
Делать платформу должна отдельная сквозная команда: в IT-вертикали или в отдельной AI-вертикали. Не команда внутри одной бизнес-функции, потому что платформой будет пользоваться вся компания.
Экспертиза команды и платформа — это и есть тот двигатель, который выводит вашу J-кривую со дна на рост. Первые внедрения идут многие месяцы. Когда появляются опытная команда и платформа, ждите кратного ускорения.
Заключение: процесс, а не пилоты
Подведём итог. Большинство компаний внедряют AI россыпью пилотов: суммаризация здесь, чат-бот там. Каждый выглядит разумно, а вместе они не сдвигают ни одной цифры. Компания тратит деньги на технологию, но не вкладывается в перестройку, и навсегда застревает на дне J-кривой.
Выбраться оттуда можно только системно:
- Выберите ключевые функции. Те, что сильнее всего влияют на операционную прибыль. Найдите в них бутылочные горлышки с intelligence-работой.
- Перестраивайте процессы, а не ускоряйте шаги. Копилот даёт 20%. Перестройка, где агент закрывает простые случаи, а человек переходит на контроль, даёт кратный эффект.
- Найдите спонсора. Топ-менеджера, чьи KPI или P&L растут от этой разработки.
- Ешьте AI-торт по кусочкам. Стадии по возрастанию сложности, в каждой PoC и масштабирование, между ними гейты. На каждой стадии растёт метрика.
- Управляйте R&D как параноик. Сначала самые дешёвые проверки блокеров, не бойтесь закрывать проекты. А если на кону не куча денег — побудьте ждуном.
- Растите своих экспертов. Вендоры помогут с технической работой, но трансформацией должен управлять внутренний AI-офис.
- Стройте платформу, но не сразу. После первых успехов — отдельным треком и отдельной командой.
Компьютерам на выход из J-кривой понадобилось лет десять, электричеству — сорок. У нас есть шанс пройти её быстрее. Для этого хватит двух вещей: перестать покупать билетики в лотерее пилотов и перестать посыпать старые процессы AI-пылью. А вместо этого начать изобретать их заново.
В более сжатом формате весь этот подход я собрал на странице «Метод». Можете перечитать основные мысли там.
Если после прочтения остались вопросы, как выстроить AI-трансформацию, — пишите в личные сообщения. Вместе разберёмся.